Circuit Breakers và Cách các kĩ sư Grab thiết kế hệ thống phản ứng lỗi (Phần 1)
Bài đăng này là phần đầu tiên trong một loạt hai phần về Circuit Breakers và Retries, nơi chúng tôi sẽ giới thiệu và so sánh hai khái niệm thường được sử dụng này. Đối với Phần 1, chúng tôi sẽ tập trung vào các trường hợp sử dụng để triển khai circuit breakers, bao gồm các tùy chọn khác nhau liên quan đến cấu hình các circuits.
Mọi thứ nên hoạt động một cách đơn giản. Đó là mong đợi cơ bản nhất mà bất kỳ người sử dụng nào đều có đối với một nhà cung cấp dịch vụ. Nhưng giống như thời tiết xấu là không thể tránh khỏi và thường không dự đoán được, thì lỗi phần mềm và phần cứng cũng vậy. Đó là lý do tại sao các kỹ sư phần mềm lên kế hoạch và tính đến các sự cố.
Trong bài viết đầu tiên của loạt hai phần này, chúng tôi sẽ bắt đầu giới thiệu và so sánh hai cơ chế độ tin cậy dịch vụ thường được sử dụng: Circuit Breakers và Retries. Tại Grab, chúng tôi sử dụng cả hai cơ chế này một cách rộng rãi trong nhiều hệ thống phần mềm của chúng tôi để đảm bảo rằng chúng ta có thể vượt qua các sự cố và tiếp tục cung cấp các dịch vụ mà khách hàng mong đợi từ chúng tôi. Nhưng liệu cả hai cơ chế này có giống nhau không? Ở đâu và làm thế nào chúng ta quyết định chọn cái này mà không phải cái còn lại?
Trong loạt bài này, chúng ta sẽ xem xét kỹ lưỡng cả hai phương pháp và các trường hợp sử dụng của chúng, để giúp bạn đưa ra quyết định khi nào và làm thế nào áp dụng mỗi phương pháp. Nhưng hãy bắt đầu bằng cách xem xét những nguyên nhân phổ biến dẫn đến sự cố. Với các dịch vụ của chúng ta liên lạc với nhiều nguồn tài nguyên bên ngoài, sự cố có thể phát sinh do:
- Vấn đề mạng
- Quá tải hệ thống
- Thiếu nguồn tài nguyên (ví dụ: hết bộ nhớ)
- Triển khai/ cấu hình không đúng
- Yêu cầu không hợp lệ (ví dụ: thiếu thông tin xác thực, dữ liệu yêu cầu bị thiếu)
Nhưng thay vì nghĩ về tất cả các cách mà một request đến một dịch vụ upstream có thể thất bại, thì thường dễ dàng hơn nếu xem xét điều gì là một request thành công. Nó nên được thực hiện đúng thời gian, trong định dạng dự kiến và chứa đựng dữ liệu mong muốn. Nếu chúng ta đi theo định nghĩa này, thì mọi thứ khác đều là một loại sự cố, dù đó là:
- Phản hồi chậm
- Không có phản hồi gì cả
- Phản hồi ở định dạng không đúng
- Phản hồi không chứa dữ liệu mong muốn
Trong kế hoạch xử lý sự cố, chúng ta nên cố gắng để có thể xử lý mỗi loại lỗi này, giống như chúng ta nên cố gắng ngăn chặn dịch vụ của mình gặp phải các lỗi đó. Vì vậy, hãy bắt đầu xem xét các kỹ thuật khác nhau để đối phó với những lỗi này.
(Lưu ý: Tất cả các ví dụ và công cụ được đề cập trong bài viết này đều sử dụng ngôn ngữ lập trình Go. Tuy nhiên, không yêu cầu kiến thức trước về Go, chỉ là một điểm thuận lợi hơn để bắt đầu.)
Giới thiệu về Circuit Breaker
Bạn có bao giờ trải qua tình trạng mất điện chưa? Có thể bạn đã bật một thiết bị lỗi, làm tối cả ngôi nhà của bạn. Bóng tôi` có thể là phiền phức, nhưng chắc chắn là tốt hơn so với việc gặp sự cố cháy nổ hoặc bị điện giật!
Thiết bị trong hộp điện của bạn đang bảo vệ bạn được gọi là circuit breaker. Thay vì để điện chạy qua thiết bị lỗi và có thể gây ra nhiều vấn đề hơn, nó đã phát hiện lỗi và đã ngắt kết nối.
Các circuit breakers trong phần mềm hoạt động theo cách tương tự. Một circuit breaker là một cơ chế đặt giữa 2 đoạn mã và theo dõi health của mọi thứ đang chảy qua nó. Tuy nhiên, thay vì dừng điện khi có sự cố, nó chặn các request.
Một request có "happy path" khi nó đi từ một service đến một upstream service có dạng như sau:
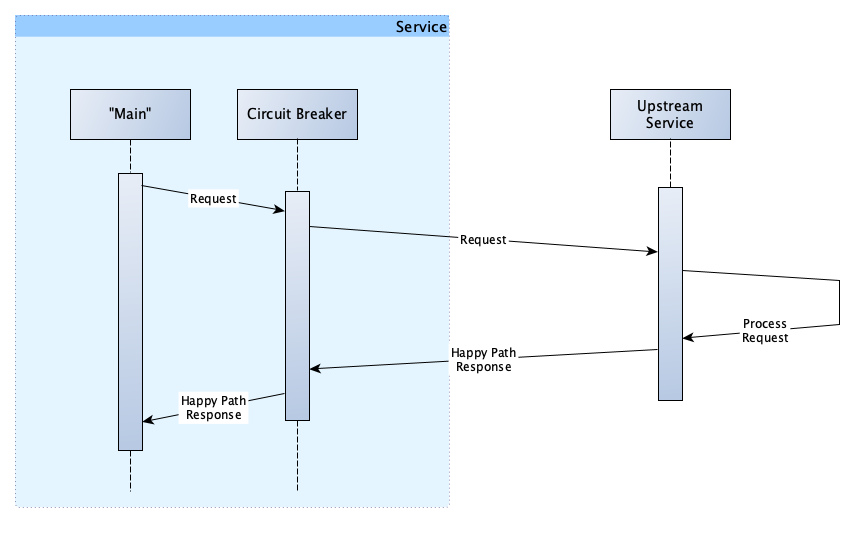
Trong tình huống của người dùng, "main" của chúng ta gọi circuit breaker (cũng nằm trong mã nguồn của chúng tôi), sau đó circuit breaker thực hiện yêu cầu đến upstream service. Upstream service xử lý yêu cầu và gửi một phản hồi. Circuit breaker nhận phản hồi và nếu không có lỗi, trả nó lại cho người gọi ban đầu.
Bây giờ, hãy xem xét điều gì xảy ra khi upstream service gặp sự cố.
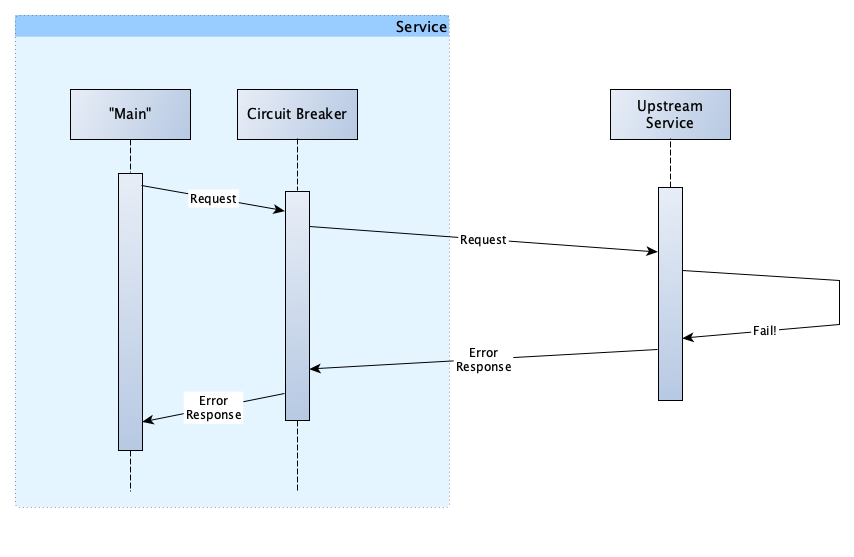
Request path vẫn giữ nguyên. Tại điểm này, bạn có thể đang tự hỏi chúng ta đã đạt được điều gì từ việc này khi request của chúng ta vẫn thất bại. Bạn đúng, đối với request cụ thể này, chúng ta không đạt được gì. Tuy nhiên, hãy giả sử rằng tất cả các request trong vòng 3 giây qua đều thất bại. Circuit breaker đã theo dõi những request này và ghi lại số lượng request nào đã thành công và bao nhiêu request đã thất bại. Khi nó nhận thức rằng tất cả các request đều thất bại, vì vậy thay vì thực hiện bất kỳ request nào khác, nó ngắt circuit, ngăn chặn bất kỳ request nào khác được gửi tới Upstram Service. Luồng của chúng ta giờ đây trông như sau:
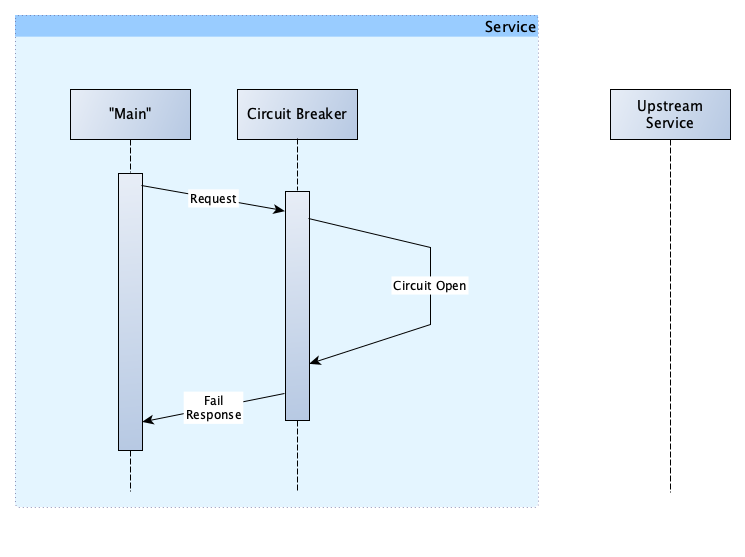
Có vẻ như chúng ta vẫn chưa đạt được điều gì. Nhưng chúng ta đã đạt được.
Hãy xem xét cuộc trò chuyện trước đó của chúng ta về cách các service có thể gặp sự cố: Service có thể gặp sự cố khi chúng bị overloaded bởi các request. Khi một dịch vụ bị overloaded, việc thực hiện thêm request có thể dẫn đến hai vấn đề. Thứ nhất, việc thực hiện request có lẽ là vô nghĩa, vì chúng ta không nhận được một response hợp lý và/hoặc đúng thời gian. Thứ hai, bằng cách tạo ra thêm request, chúng ta không cho phép upstream service hồi phục từ tình trạng overloaded và thực tế, có thể làm overloaded nó thêm nữa.
Nhưng circuit breakers không chỉ là về việc trở thành good user và bảo vệ upstream service của chúng ta. Chúng cũng mang lại lợi ích cho service của chúng ta như chúng ta sẽ thấy trong các phần tiếp theo.
Fallback
Circuit breakers, như Hystrix, bao gồm khả năng xác định một fallback. Luồng với fallback có sẽ như sau:
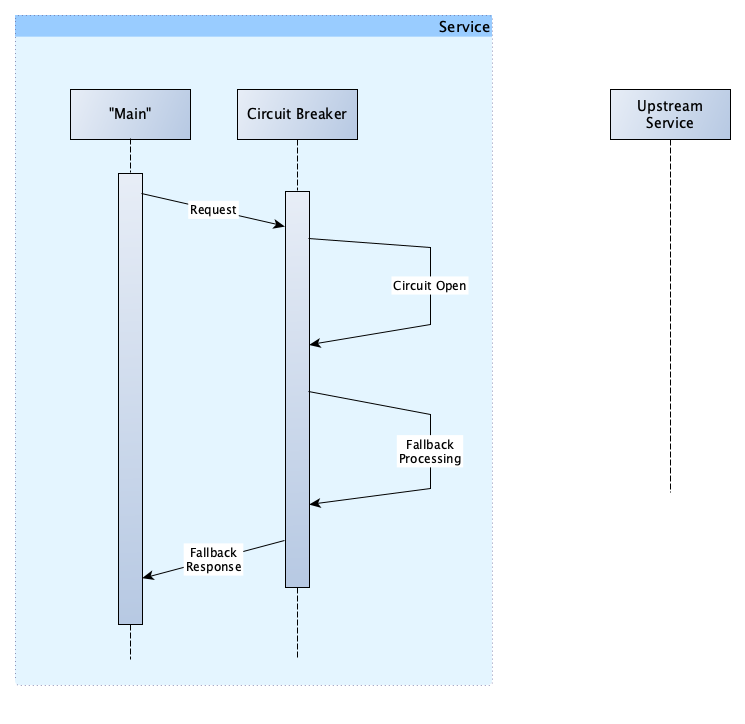
Vậy thì điều đó mang lại cho chúng ta gì? Hãy xem xét một ví dụ. Giả sử bạn đang viết một service ước tính khoảng cách đi lại giữa 2 địa điểm.
Nếu mọi thứ đang hoạt động như mong đợi, chúng ta sẽ gọi "distance calculator service", cung cấp cho nó các địa điểm bắt đầu và kết thúc, và nó sẽ trả về khoảng cách. Tuy nhiên, dịch vụ đó đang tạm thời không hoạt động. Một lựa chọn thay thế hợp lý trong tình huống này có thể là ước lượng khoảng cách bằng cách sử dụng một số hàm toán học. Tất nhiên, việc tính toán khoảng cách theo cách này có thể không chính xác, nhưng việc sử dụng một giá trị không chính xác nhưng cho phép chúng ta tiếp tục xử lý yêu cầu của người dùng là tốt hơn là trả về một kết quả thất bại cho người dùng.
Trong xử lý fallback, việc sử dụng một giá trị ước lượng thay vì giá trị chính xác không phải là lựa chọn duy nhất, các lựa chọn phổ biến khác bao gồm:
- Thử lại request bằng cách sử dụng một upstream service khác
- Đặt lịch request cho một thời điểm sau
- Tải dữ liệu có thể đã lỗi thời từ bộ đệm
Tất nhiên, có những trường hợp không có lựa chọn thay thế hợp lý. Nhưng ngay cả trong những tình huống này, việc sử dụng một circuit breaker vẫn mang lại lợi ích.
Hãy xem xét chi phí của việc thực hiện và chờ đợi một request cuối cùng thất bại. Có tài nguyên CPU, bộ nhớ và network đều đang được sử dụng để thực hiện request và đợi phản hồi. Sau đó là phản hồi chậm trễ đối với người dùng của bạn.
Tất cả những chi phí này đều được tránh khi circuit bị mở, vì yêu cầu không được thực hiện mà ngay lập tức thất bại. Mặc dù việc trả về một lỗi cho người dùng của chúng ta không phải là lựa chọn lý tưởng, nhưng việc trả về lỗi nhanh nhất có thể là lựa chọn tốt nhất trong những tình huống xấu nhất.
Circuit Breaker có nên tracking tất cả các lỗi hay không
Câu trả lời là không. Chúng ta chỉ nên theo dõi những lỗi không phải do người dùng gây ra (tức là mã lỗi HTTP 400 và 401), mà là do mạng hoặc cơ sở hạ tầng (tức là mã lỗi HTTP 503 và 500).
Nếu chúng ta theo dõi những lỗi do người dùng gây ra, thì sẽ có khả năng một người dùng độc hại gửi một số lượng lớn yêu cầu không hợp lệ, khiến cho mạch của chúng ta mở và tạo ra sự cố dịch vụ cho tất cả mọi người.
Circuit Recovery
Chúng ta đã nói về cách circuit breaker có thể mở mạch và cắt khi có quá nhiều lỗi. Chúng ta cũng nên hiểu về cách mạch trở lại trạng thái đóng.
Khác với ví dụ về điện mà chúng ta đã sử dụng ở trên, với một software circuit breaker, bạn không cần phải tìm hộp cầu dao trong bóng tối và đóng mạch bằng tay.Software Circuit breaker có thể tự đóng mạch.
Sau khi circuit breaker mở mạch, nó sẽ chờ một khoảng thời gian (có thể được cấu hình), gọi là Sleep Window, sau đó nó sẽ kiểm tra mạch bằng cách cho phép một số request đi qua. Nếu dịch vụ đã hồi phục, nó sẽ đóng mạch và tiếp tục hoạt động bình thường. Nếu các yêu cầu vẫn trả về lỗi, thì nó sẽ lặp lại quá trình sleep/try cho đến khi hồi phục.
Bulwark
Tại Grab, chúng tôi sử dụng circuit breaker Hystrix-Go, và việc thiết lập này bao gồm một thành phần bảo vệ có tên là "bulwark". Một bulwark là một quy trình phần mềm theo dõi số lượng yêu cầu đến đồng thời (concurent request) và có khả năng ngăn chặn việc thực hiện nhiều hơn số lượng concurent request tối đa được cấu hình. Đây là một hình thức rate-limiting (giới hạn tỷ lệ) rất hiệu quả.
Trong trường hợp của chúng tôi, việc ngăn chặn quá nhiều concurent request được thực hiện bằng cách mở mạch (như chúng ta đã thấy ở trên). Quá trình này không được tính vào số lượng lỗi và sẽ không ảnh hưởng trực tiếp đến các tính toán khác.
Vậy tại sao điều này quan trọng? Như chúng ta đã nói trước đó, có khả năng các dịch vụ trở nên không phản hồi (hoặc thậm chí là crash) khi nhận được quá nhiều concurent request
Hãy xem xét tình huống sau: Một hacker quyết định tấn công service của bạn bằng một cuộc tấn công DOS. Bất ngờ, service của bạn đang nhận được gấp 100 lần số lượng yêu cầu thông thường. Service của bạn có thể thực hiện gấp 100 lần số lượng yêu cầu lên upstream service của bạn.
Nếu upstream của bạn không thực hiện một hình thức rate-limiting nào đó, với số lượng yêu cầu nhiều như vậy, nó có thể sẽ crash. Bằng cách giới thiệu một bulwark giữa dịch vụ của bạn và upstream, bạn đạt được hai điều:
- Bạn không làm đổ vỡ upstream service vì bạn giới hạn số lượng request mà nó không thể xử lý.
- Các "extra" request bị thất bại bởi bulwark có cả khả năng fallback và khả năng thất bại nhanh chóng.
Cài đặt Circuit Breaker
Circuit Breaker Hystrix-Go có 5 cài đặt, đó là:
Timeout
Thời lượng này là thời gian tối đa mà một yêu cầu được phép thực hiện trước khi chúng được coi là một lỗi. Điều này xem xét rằng không phải tất cả các request đến upstream service đều sẽ thất bại ngay lập tức.
Với điều này, chúng ta có thể giới hạn tổng thời gian mà chúng ta phải mất để xử lý một yêu cầu bằng cách xác định thời gian chúng ta sẵn lòng đợi từ upstream service của chúng ta.
Max Concurrent Requests
Đây chính là cài đặt của bulwark (như đã đề cập ở trên).
Hãy xem xét rằng giá trị mặc định (10) chỉ đại diện cho các concurent request và không phải là "mỗi giây". Do đó, nếu các yêu cầu thường nhanh chóng (hoàn thành trong vài mili giây), thì không cần phải cho phép nhiều hơn.
Ngoài ra, việc đặt giá trị này quá cao có thể khiến dịch vụ của bạn thiếu tài nguyên (bộ nhớ, CPU, cổng) cần thiết để thực hiện các yêu cầu.
Request Volume Threshold
Đây là số lượng yêu cầu tối thiểu phải được thực hiện trong khoảng đánh giá (rolling window) trước khi mạch có thể được mở.
Cài đặt này được sử dụng để đảm bảo rằng không mở mạch trong trường hợp có lỗi xuất hiện trong volume này
Sleep Window
Đây là thời lượng mà circuit chờ đợi trước khi circuit breaker cố gắng kiểm tra tình trạng của các yêu cầu (như đã đề cập ở trên).
Nếu đặt quá thấp, sẽ giới hạn hiệu quả của circuit breaker vì nó mở/kiểm tra quá thường xuyên. Tuy nhiên, nếu đặt thời lượng này quá cao, sẽ giới hạn thời gian để phục hồi.
Error Percent Threshold
Đây là phần trăm số request thất bại trước khi ngắt mạch.
Nhiều yếu tố nên được xem xét khi đặt giá trị này, bao gồm:
- Số lượng máy chủ trong upstream service (thêm thông tin trong phần tiếp theo)
- Độ tin cậy của upstream servicevà kết nối của bạn đến nó
- Độ nhạy cảm của dịch vụ đối với lỗi
- Sở thích cá nhân
Circuit Configuration
Trong những phần tiếp theo, chúng ta sẽ thảo luận về một số tùy chọn khác liên quan đến cấu hình của circuit, đặc biệt là cấu hình theo máy chủ và theo dịch vụ, cũng như cách chúng ta, những người lập trình, định nghĩa circuit.
Trong Hystrix-Go, mô hình sử dụng điển hình trông như sau:
hystrix.Go("my_command", func() error {
    // talk to other services
    return nil
}, func(err error) error {
    // do this when services are down
    return nil
})
Tham số đầu tiên "my_command" là tên của circuit. Điều đầu tiên cần chú ý ở đây là vì tên circuit là một tham số, cùng một giá trị có thể được cung cấp cho nhiều lời khởi tạo của circuit breaker.
Điều này mang lại một số side effect thú vị.
Giả sử dịch vụ của bạn gọi đến nhiều endpoint của một upstream service có tên là 'list', 'create', 'edit' và 'delete'. Nếu chúng ta muốn theo dõi tỷ lệ lỗi của mỗi endpoint này một cách riêng biệt, bạn có thể định nghĩa circuit như sau:
func List() {
   hystrix.Go("my_upstream_list", func() error {
      // call list endpoint
      return nil
   }, nil)
}
func Create() {
   hystrix.Go("my_upstream_create", func() error {
      // call create endpoint
      return nil
   }, nil)
}

func Update() {
   hystrix.Go("my_upstream_update", func() error {
      // call update endpoint
      return nil
   }, nil)
}

func Delete() {
   hystrix.Go("my_upstream_delete", func() error {
      // call delete endpoint
      return nil
   }, nil)
}
Bạn sẽ nhận thấy rằng tôi đã thêm tiền tố "my_upstream_" cho tất cả các circuit và sau đó thêm tên của điểm cuối. Điều này tạo ra 4 mạch cho 4 endpoint
Ngược lại, nếu chúng ta muốn theo dõi tất cả các lỗi liên quan đến một distination, chúng ta có thể định nghĩa các mạch như sau:
func List() {
   hystrix.Go("my_upstream", func() error {
      // call list endpoint
      return nil
   }, nil)
}

func Create() {
   hystrix.Go("my_upstream", func() error {
      // call create endpoint
      return nil
   }, nil)
}

func Update() {
   hystrix.Go("my_upstream", func() error {
      // call update endpoint
      return nil
   }, nil)
}

func Delete() {
   hystrix.Go("my_upstream", func() error {
      // call delete endpoint
      return nil
   }, nil)
}
Trong ví dụ trên, tất cả các call endpoint khác nhau đều sử dụng cùng một tên circuit.
Vậy làm thế nào chúng ta quyết định chọn cái nào? Trong trương hợp lý tưởng, một circuit cho mỗi upstream endpoint là đủ. Điều này là do tất cả các lỗi đều liên quan đến cơ sở hạ tầng (ví dụ: mạng) và trong những trường hợp này, khi request đến một endpoint thất bại, chắc chắn tất cả đều sẽ thất bại. Phương pháp này sẽ dẫn đến việc circuit được mở trong thời gian ngắn nhất có thể, giảm thiểu tỷ lệ lỗi của chúng ta.
Tuy nhiên, phương pháp thứ nhất giả định rằng upstream service của chúng ta không thể thất bại theo cách mà một endpoint bị hỏng và các endpoint khác vẫn hoạt động. Nó cũng giả định rằng việc xử lý phản hồi từ upstream service của chúng ta không bao giờ mắc lỗi. Ví dụ, nếu chúng ta tình cờ theo dõi lỗi người dùng trong một trong những cuộc gọi bộ chia mạch của chúng ta, chúng ta có thể nhanh chóng bị cấm thực hiện bất kỳ cuộc gọi nào đến upstream.
Do đó, mặc dù việc có một circuit cho mỗi endpoint dẫn đến việc circuit mở chậm hơn một chút,nhưng đây vẫn là phương pháp mà tôi khuyến khích. Quan trọng hơn là thực hiện càng nhiều request thành công càng tốt, thay vì mở mạch không đúng cách.
Một Circuit cho mỗi Service
Chúng ta đã nói về các upstream service như chúng là một điểm đích duy nhất, và khi đối mặt với cơ sở dữ liệu hoặc bộ nhớ cache, điều này có thể đúng. Nhưng khi xử lý với API/service, điều này hiếm khi xảy ra.
Nhưng tại sao điều này lại quan trọng? Hãy nhớ lại các cuộc thảo luận trước đó về cách một dịch vụ có thể gặp sự cố. Nếu máy chạy upstream service của chúng ta gặp vấn đề về tài nguyên (hết bộ nhớ, hết CPU, hoặc disk đầy), đây là những vấn đề tập trung ở máy đó. Vì vậy, nếu một máy gặp vấn đề về tài nguyên, điều này không có nghĩa là tất cả các máy khác hỗ trợ dịch vụ đó sẽ gặp cùng một vấn đề.
Khi chúng ta chỉ có một circuit breaker cho tất cả các request đến một tài nguyên hoặc dịch vụ cụ thể, chúng ta đang sử dụng circuit breaker trong một mô hình "per service". Hãy xem một số ví dụ để xem điều này ảnh hưởng đến hành vi của circuit breaker.
Trước hết, khi chúng ta chỉ có 1 điểm đích, thường là trường hợp của cơ sở dữ liệu:
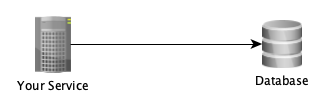
Nếu tất cả request đến một điểm đích duy nhất (ví dụ: cơ sở dữ liệu) đều thất bại, thì tỷ lệ lỗi của chúng ta sẽ là 100%.
Circuit breaker chắc chắn sẽ mở, và điều này là điều ta mong muốn vì cơ sở dữ liệu không thể phản hồi đúng cách và các yêu cầu tiếp theo sẽ lãng phí tài nguyên.
Bây giờ hãy xem xét điều gì sẽ xảy ra khi chúng ta thêm một load balancer và nhiều server hơn:
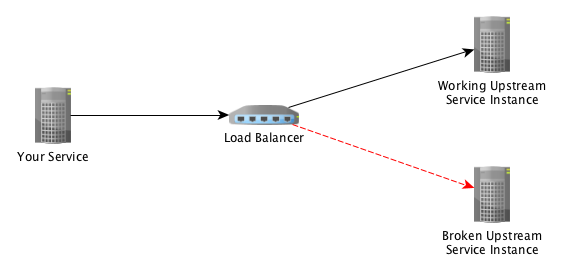
Giả sử sử dụng load balancer theo thuật toán round-robin, tất cả request đến một máy chủ thành công và tất cả request đến máy chủ khác thất bại. Điều này chỉ ra: 1 bad host / tổng số 2 host = tỷ lệ lỗi 50%.
Nếu chúng ta đặt Ngưỡng Phần Trăm Lỗi (Error Percent Threshold) của mình là bất kỳ giá trị nào lớn hơn 50%, thì mạch sẽ không mở, và chúng ta sẽ thấy 50% yêu cầu của chúng ta thất bại. Ngược lại, nếu chúng ta đặt Ngưỡng Phần Trăm Lỗi của mình là ít hơn 50%, mạch sẽ mở và tất cả các yêu cầu sẽ chuyển hướng đến xử lý fallback hoặc thất bại.
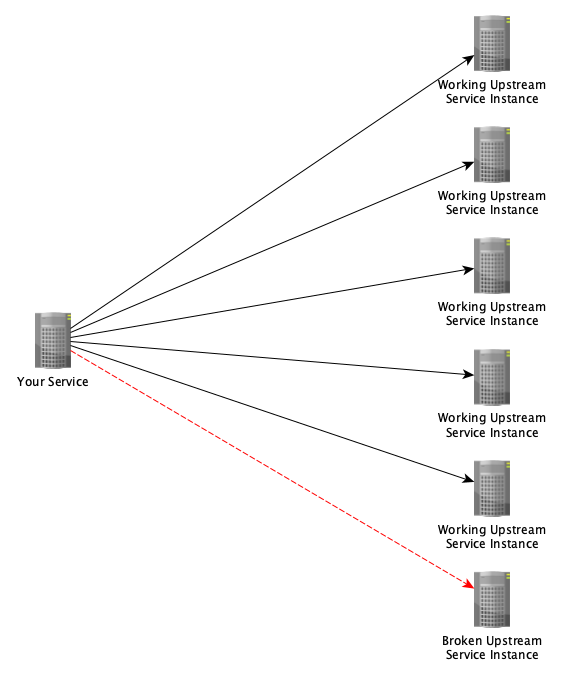
Bây giờ, nếu chúng ta thêm các máy chủ bổ sung vào dịch vụ upstream như sau:
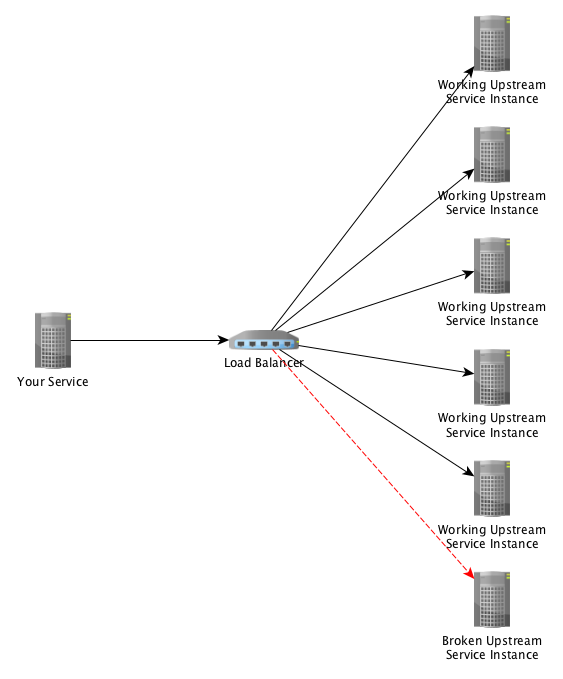
Sau đó, tính toán và ảnh hưởng của một trường hợp xấu thay đổi một cách đáng kể. Kết quả của chúng ta trở thành: 1 bad host / tổng số 6 host = tỷ lệ lỗi 16,66%.
Có một số điều chúng ta có thể suy luận từ ví dụ mở rộng này:
- Một trường hợp xấu sẽ không làm mở mạch (làm ngăn chặn tất cả các yêu cầu hoạt động).
- Thiết lập một tỷ lệ lỗi rất thấp (ví dụ: 10%), làm cho mạch mở vì một bad host sẽ là vô ích, vì chúng ta có 5 máy chủ khác có thể phục vụ các yêu cầu.
- Các circuit breaker trong cấu hình "per service" chỉ nên mở mạch khi hầu hết (hoặc tất cả) các máy chủ đích không tốt.
Một Circuit cho mỗi Host
Như chúng ta đã thấy ở trên, có khả năng một máy chủ không tốt có thể ảnh hưởng đến circuit của bạn, vì vậy bạn có thể xem xét việc có một mạch cho mỗi upstream service đích.
Tuy nhiên, để đạt được điều này, dịch vụ của chúng tôi phải biết về số lượng và danh tính của các máy chủ đích upstream. Trong ví dụ trước đó, nó chỉ biết về sự tồn tại của load balancer. Do đó, nếu chúng ta loại bỏ load balancer khỏi ví dụ trước đó của chúng ta, chúng ta sẽ có điều này:
Với cấu hình này, một máy chủ không tốt không thể ảnh hưởng đến các circuit theo dõi các máy chủ khác. Cảm giác như là một chiến thắng.
Tuy nhiên, sau khi loại bỏ trình cân bằng tải, service của chúng ta bây giờ phải đảm nhận trách nhiệm đó và thực hiện load balancer phía client.
Để có thể thực hiện load balancer phía client, service của chúng ta phải theo dõi sự tồn tại và tình trạng của tất cả các máy chủ trong upstream service và cân bằng các yêu cầu trên các máy chủ. Tại Grab, nhiều dịch vụ dựa trên gRPC của chúng tôi được cấu hình theo cách này.
Với cấu hình mới của chúng tôi, chúng tôi đã gặp thêm một số phức tạp bổ sung liên quan đến cân bằng tải phía client, và chúng tôi cũng đã chuyển từ 1 circuit thành 6 circuit. 5 circuit bổ sung này cũng gây ra một lượng tài nguyên (tức là bộ nhớ) chi phí. Trong ví dụ này, có vẻ như không nhiều, nhưng khi chúng ta áp dụng thêm các upstream service và số lượng máy chủ upstream tăng lên, chi phí sẽ nhân lên.
Điều cuối cùng chúng ta nên xem xét là cách cấu hình này sẽ ảnh hưởng đến khả năng của chúng ta trong việc đáp ứng các yêu cầu. Khi máy chủ trở nên không tốt, tỷ lệ lỗi trong các yêu cầu của chúng tôi sẽ giống như trước đó: 1 máy chủ xấu / 6 tổng số máy chủ = tỷ lệ lỗi 16.66%
Tuy nhiên, sau khi đủ lỗi xảy ra để mở mạch đến máy chủ không tốt của chúng tôi, chúng ta sẽ có thể tránh việc gửi yêu cầu đến máy chủ đó và chúng ta sẽ tiếp tục có tỷ lệ lỗi 0%.
Suy nghĩ về mỗi Service so với mỗi Host
Dựa trên cuộc thảo luận ở trên, bạn có thể muốn nhanh chóng chuyển đổi tất cả các circuit của mình thành per host. Tuy nhiên, bạn không nên đánh giá thấp sự phức tạp bổ sung khi làm như vậy.
Hơn nữa, chúng ta cũng nên xem xét phản ứng của load balancer trong trường hợp per service của chúng ta khi máy chủ xấu gặp sự cố. Nếu load balancer trong ví dụ per service của chúng ta được cấu hình để giám sát sức khỏe của dịch vụ đang chạy trên mỗi máy chủ (và không chỉ là sức khỏe của máy chủ chính nó), thì nó có thể phát hiện và loại bỏ máy chủ đó khỏi load balancer và có thể thay thế nó bằng một máy chủ mới.
Có thể sử dụng cả per service và per host cùng một lúc (mặc dù tôi chưa bao giờ thử). Trong cấu hình này, mạch per service chỉ nên mở khi có ít cơ hội có bất kỳ máy chủ hợp lệ nào, và bằng cách làm như vậy, nó sẽ tiết kiệm thời gian xử lý yêu cầu mà mất đi qua chu kỳ thử lại. Cấu hình cho điều này phải là: Circuit Breaker (per service) → Retry → Circuit Breaker (per host).
Lời khuyên của tôi là xem xét cách và tại sao dịch vụ upstream của bạn có thể gặp sự cố, sau đó sử dụng cấu hình đơn giản nhất có thể cho tình huống của bạn.
Tiếp theo, Retries…
Vậy là chúng ta đã xem xét cơ chế đầu tiên thường được sử dụng trong thiết kế đối với độ tin cậy, đó là Circuit Breakers. Hy vọng bạn đã thích thú với bài viết này và tìm thấy nó hữu ích. Nhận xét, sửa lỗi, và thậm chí là những ý kiến không đồng tình cũng luôn được hoan nghênh.
Trong bài viết tiếp theo của chúng tôi, chúng ta sẽ xem xét cơ chế reliability khác, đó là Retries. Chúng ta sẽ tìm hiểu cách nó hoạt động, cách cấu hình, và giải quyết một số triển khai với backoff và jitter. Chúng ta cũng sẽ thảo luận về khi nào nên sử dụng circuit breakers so với retries, hoặc thậm chí là sự kết hợp của cả hai.
Hãy đồng hành và đón xem!