MongoDB GridFS
Trong thời đại ngày nay, việc lưu trự những dữ liệu phi cấu trúc (unstructured data) như là aidio, video hay hình ảnh là một yêu cầu thiết thực và cực kỳ quan trọng. Tuy nhiên , những data dạng đó thường có kích thước lớn và chiếm một lượng lớn không gian dùng để lưu trữ chúng. Trong bài viết này , chúng ta cùng tìm hiểu về cách mà MongoDB giải quyết vấn đề đó bằng công cụ GridFS.
BSON Document và giới hạn kích thước
Như chúng ta đã biết, MongoDB lưu trữ data dưới dạng BSON (Binary JSON). Và giới hạn kích thước cho mỗi Document là 16MB. Sở dĩ MongoDB đề ra giới hạn như vậy để đảm bảo câu query được ổng định và mỗi document sẽ không chiếm dụng lượng lớn RAM hay băng thông trong 1 transaction.
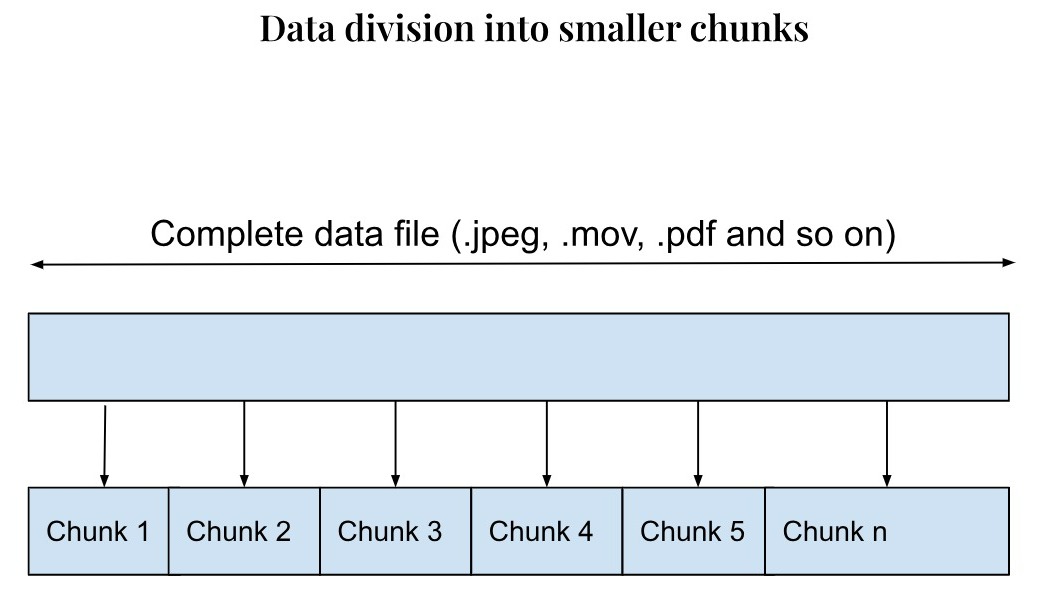
Và đây là lúc GridFS xuất hiện, GridFS chia nhỏ các file có kích thước lớn thành cái thành phần nhỏ hơn , gọi là chunk. Sau đó , khi file này được gọi, GridFS sẽ ghép nối các chunk này thành file hoàn chính để trả về cho người dùng. Một lưu ý cần nhớ là mỗi chunk này là những binary chunk của file được split ra.
GridFS Bucket
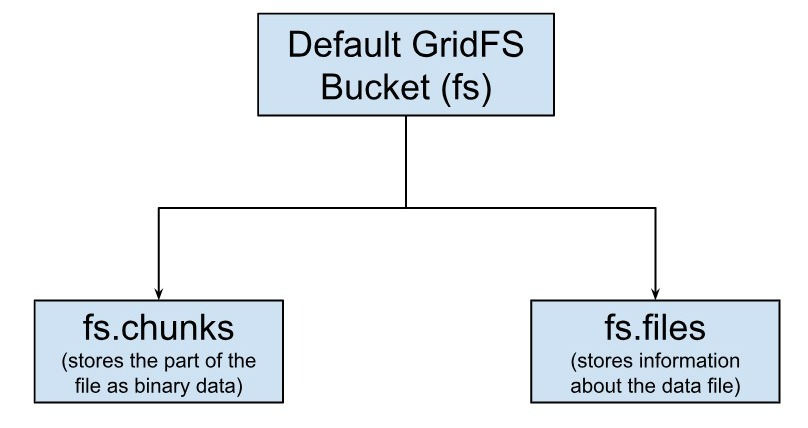
MongoDB sử dụng GridFS Bucket để lưu trữ hai Collection nhằm lưu trữ các chunk. Theo mặc định, các collection này là fs.chunks và fs.files , chúng ta có thể đổi tên của Bucket này hoặc tạo thêm những Bucket khác
- Collection fs.chunks dùng để lưu trữ các chunk của file dưới dạng binary
- Collection fs.files dùng để lưu trữ thông tin của file như fileName, size hay các metadata
Bây giờ chúng ta cùng đi sâu tìm hiểu về chông dụng của 2 Colelction này
Chunk Collection
Mỗi phân đoạn của data được lưu trữ trong 1 document riêng biệt trong 1 collection có tên là ‘chunks’. Mặc định , MongoDB cung cấp cho mỗi document một mã định danh duy nhất, cùng với các trường khác. Đây là một tính năng rất quan trọng vì bạn có thể truy xuất một phần dữ liệu nếu muốn thay vì toàn bộ dữ liệu. Sau đó, chỉ phần dữ liệu bạn muốn mới được tải vào bộ nhớ, do đó nâng cao hiệu suất và hiệu quả của hệ thống.
Chà, trong trường hợp đó, bạn cũng có thể sử dụng GridFS để lưu trữ các tệp có thể nhỏ hơn 16 MB, nhưng bạn vẫn muốn chia nhỏ dữ liệu và chỉ truy xuất các phần của dữ liệu đó theo yêu cầu để tiết kiệm bộ nhớ.
Ngoại trừ chunk cuối cùng, mỗi đoạn dữ liệu có kích thước tối đa là 255 kb.
Chúng ta hãy xem ví dụ về một document được lưu trữ trong collection fs.chunks:
{
    "_id": ObjectId("554a76f34f54bfzc8a3ex04d"),
    "files_id": ObjectId("223a75g19l94bxel8p2ef32y"),
    "n":NumberLong(0),
    "data": BinData(0, "+MCI+Pxf5u93g............")
}
Trường _id ở đây là mã định danh duy nhất cho chunk cụ thể của tệp. files_id đại diện cho tệp cha (Tức tệp trước khi split , dùng trường này để combine các chunk lại khi retriving data), tên của tệp này được liên kết với collection fs.files. Số 'n' biểu thị vị trí của chunk trong toàn bộ files_id và theo thứ tự từ 0 đến n-1. 'data' đại diện cho chunk dữ liệu thực tế được lưu trữ trong document.
Lưu ý rằng những thứ này được MongoDB tạo theo mặc định và bạn có thể thêm nhiều trường hơn vào các document, ví dụ: bạn có thể thêm metadata vào một số document. Điều này có thể thực hiện được nhờ sự flexible của MongoDB.
Files Collection
Vậy làm thế nào để chúng ta biết chunk thuộc về file nào? Để làm điều này, MongoDB cung cấp một collection có tên là 'file' để lưu trữ dữ liệu về các files. Collection này lưu trữ tất cả thông tin liên quan về tệp được lưu trữ.
Một ví dụ được đưa ra dưới đây:
{
  "_id": ObjectId("223a75g19l94bxel8p2ef32y"),
  "length": NumberLong("998321"),
  "content-type": "video/quicktime",
  "uploadDate": ISODate("2023-09-20T23:00:01Z"),
  "chunkSize": NumberLong("34221"),
  "filename": "star_wars.MOV",
  "author": "misc"
}
Trường _id là mã định danh duy nhất cho file. Trường length biểu thị tổng chiều dài của tệp. Tất cả các trường đều cung cấp thông tin quan trọng về tệp gốc được lưu trữ trong cơ sở dữ liệu. Bạn có thể kiểm tra danh sách đầy đủ các trường trên trang tài liệu chính thức của MongoDB. Vì MongoDB cung cấp một tính năng linh họat nên bạn cũng có thể thêm vào các trường bổ sung, tương tự như collection fs.chunks và cung cấp bất kỳ thông tin cụ thể nào khác.
GridFS hoạt động như thế nào?
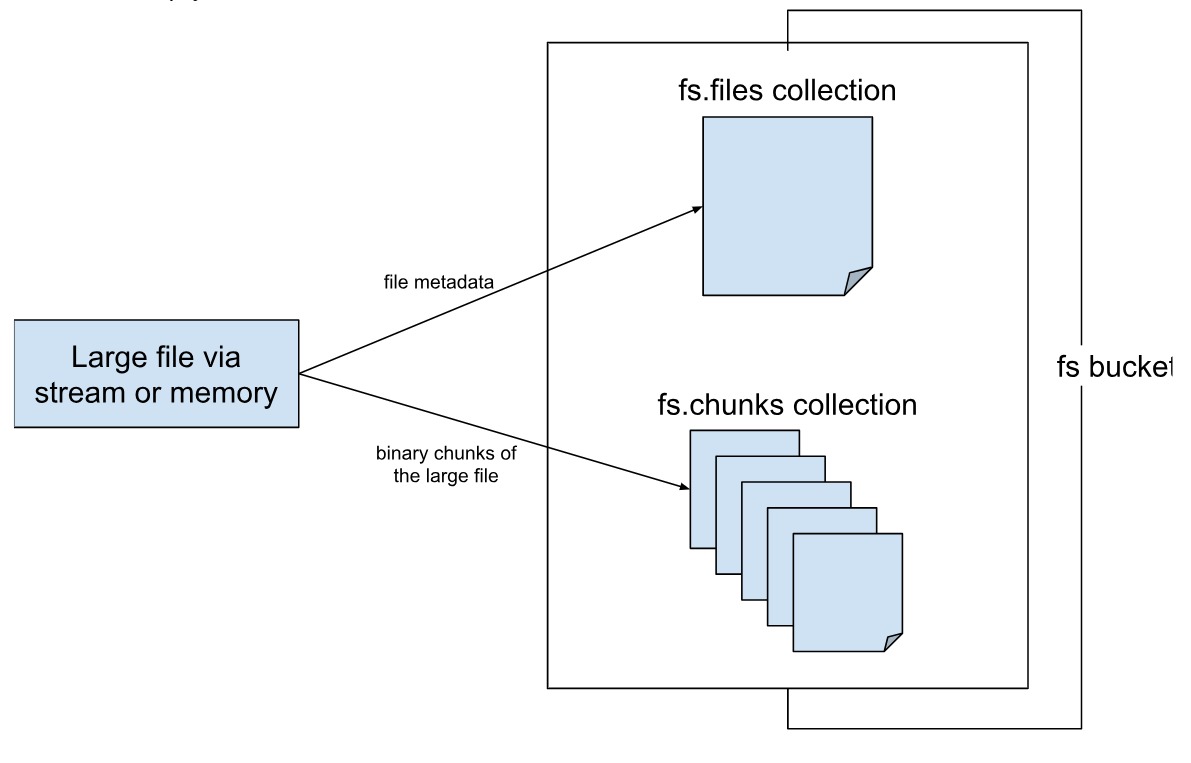
GridFS API cung cấp các phương thức giúp dễ dàng lưu trữ các tệp lớn. Sau khi bạn tải dữ liệu lên bằng memory hoặc stream, GridFS sẽ chia dữ liệu đó thành các tệp chunk nhị phân và lưu trữ dữ liệu đó vào một collection mặc định có tên fs.chunks. Nó còn tạo ra fs.files, nơi lưu trữ thông tin về tệp. Lưu ý rằng hai collection này được tự động tạo bởi MongoDB nếu chúng chưa tồn tại.
Bạn có thể tạo số lượng trường bất kỳ và thêm thông tin khác dựa theo nhu cầu vào một số document của cả hai collection. Trong khi insert dữ liệu, GridFS kiểm tra MD5 Checksum để đảm bảo rằng các chunk thuộc cùng một tệp.
Nó cũng tạo ra các chỉ mục mặc định để đảm bảo hiệu quả và tốc độ của việc combine và truy xuất các binary document.
GridFS tạo index tổng hợp trên trường files_id và n fields của collection fs.chunks. Trường files_id giúp nhanh chóng lấy tất cả các chunk được liên kết với một file và giá trị của n cho phép sắp xếp các chunk theo trình tự sau đó tiến hành combine. Trên collection fs.files, GridFS đánh index bằng cách ghép thông tin các trường filename và uploadDate. Ngoài ra, bạn cũng có thể tạo index trên các trường khác theo nhu cầu ứng dụng của bạn để nâng cao hơn nữa tốc độ truy xuất tài liệu.
MongoDB Driver chỉ tạo GridFS Bucket cho thao tác ghi đầu tiên, nếu bucket không tồn tại. Điều tương tự cũng áp dụng cho index - nếu không có index nào trên collection và bucket rỗng thì driver sẽ tạo index.
Fs trong tài liệu tham khảo của chúng tôi ngụ ý 'File System', tức là các collection và bucket được file system tạo theo mặc định. Như chúng tôi đã đề cập trong phần trước, bạn có thể tạo bucket của riêng mình và đặt tên cho nó khác với fs.
const bucket = new mongodb.GridFSBucket(db, { bucketName: 'custombucketname' });GridFS Sharding
Trong môi trường phân tán, nơi mà dữ liệu được lưu trữ thành nhiều cụm (cluster), sharding đóng vai trò quan trọng trong việc mở rộng quy mô cơ sở dữ liệu và duy trì hiệu quả của việc ghi và đọc. Bạn có thể shard cả tập tin và chunk collection riêng lẻ. Bạn có thể sử dụng Hashed Sharding trên chunk collection hoặc sử dụng { files_id : 1, n : 1 }; or { files_id : 1 } làm sharding key index. File Collection tương đối nhỏ hơn và nếu bạn chọn không sharing file collection, dữ liệu sẽ nằm trên primary shard.
Lợi ích của GridFS
Điều quan trọng cần lưu ý là GridFS cung cấp một cách đơn giản để lưu trữ tất cả các loại dữ liệu vào một kho lưu trữ duy nhất. Đây là lợi ích chính của việc sử dụng GridFS. Những lợi ích quan trọng khác là:
Bạn có thể thêm bất kỳ số trường nào vào bộ sưu tập, được cấu trúc dữ liệu linh hoạt của MongoDB cho phép và cũng có thể lấy một số phần dữ liệu nhất định, bỏ qua việc truy xuất một số phần nhất định của dữ liệu, điều này giúp tăng cường hơn nữa tính linh hoạt
Các tính năng có tính sẵn sàng cao và sharding (khả năng mở rộng) của MongoDB có thể được sử dụng cho tất cả các loại dữ liệu - phi cấu trúc và có cấu trúc, làm cho kiến trúc ứng dụng trở nên khá đơn giản để hiểu
Cơ chế bảo mật hợp lý để kiểm soát truy cập và bảo mật dữ liệu MongoDB cũng cung cấp tính linh hoạt để tạo các chỉ mục tùy chỉnh để truy vấn dữ liệu hiệu quả.
Tổng kết
Trong thế giới digital ngày nay, chúng ta tiêu thụ và tạo ra rất nhiều dữ liệu, đồng thời việc có thể lưu trữ và truy xuất dữ liệu có thể nhanh chóng trở thành nút thắt cổ chai nếu không có cơ chế hiệu quả do MongoDB cung cấp dưới dạng GridFS. Tuy nhiên, nếu bạn lưu trữ các tệp cực lớn (vài gigabyte) theo cách này, yêu cầu lưu trữ của ứng dụng của bạn có thể tăng lên và dẫn đến tăng hiệu suất hoạt động. Trước khi lưu trữ các tệp của mình trong GridFS, bạn nên xem xét cẩn thận các tác động - ví dụ: nếu bạn muốn truy cập các phần của tệp lớn nhưng không tải toàn bộ tệp - sử dụng GridFS là hoàn toàn hợp lý. Tương tự, khi bạn muốn giữ cho các tệp và siêu dữ liệu của mình được tự động đồng bộ hóa và triển khai trên một số hệ thống và cơ sở, bạn có thể sử dụng GridFS.