Amazon Athena
Amazon Athena
- Dịch vụ truy vấn serverless để phân tích dữ liệu lưu trữ trong Amazon S3
- Sử dụng ngôn ngữ SQL tiêu chuẩn để truy vấn các file (dựa trên nền tảng Presto)
- Hỗ trợ các định dạng: CSV, JSON, ORC, Avro, và Parquet
- Chi phí: $5.00 trên mỗi TB dữ liệu được quét
- Thường được sử dụng kết hợp với Amazon Quicksight để tạo báo cáo / dashboard
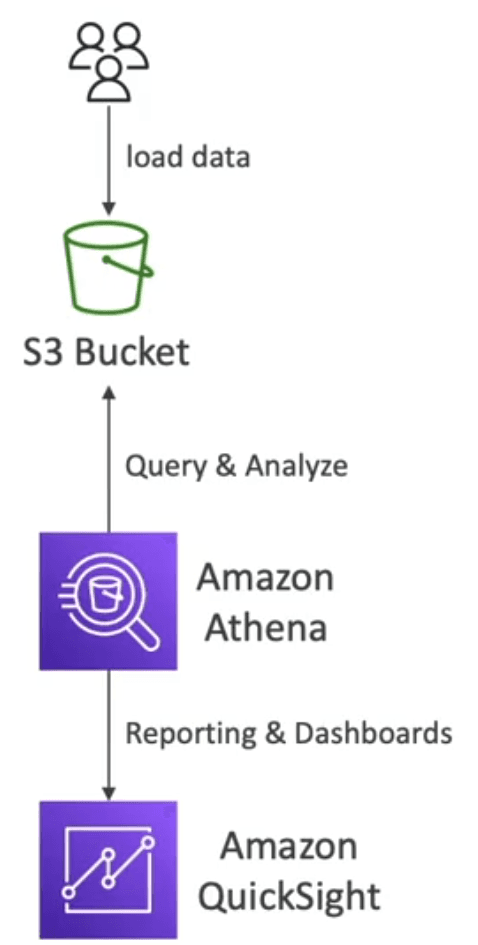
- Trường hợp sử dụng (Use cases):
- Dành cho nghiệp vụ phân tích dữ liệu doanh nghiệp, business intelligence, báo cáo, truy vấn các log như VPC Flow Logs, ELB Logs, CloudTrail trails, v.v.
- Exam Tip
- Để phân tích dữ liệu trong S3 bằng cách sử dụng SQL dạng serverless, hãy dùng Athena.
Cải thiện hiệu năng
- Sử dụng định dạng dữ liệu dạng columnar để tiết kiệm chi phí (do giảm lượng dữ liệu cần scan)
- Khuyến nghị sử dụng định dạng Apache Parquet hoặc ORC
- Tăng hiệu năng đáng kể
- Có thể dùng AWS Glue để convert dữ liệu sang định dạng Parquet hoặc ORC
- Nén dữ liệu (Compress data) để giảm dung lượng khi truy xuất
- Hỗ trợ các định dạng nén:
bzip2,gzip,lz4,snappy,zlip,zstd, v.v.
- Hỗ trợ các định dạng nén:
- Phân vùng dữ liệu (Partition datasets) trong S3 để dễ dàng truy vấn bằng cách sử dụng virtual columns
- Cấu trúc thư mục ví dụ:
s3://yourBucket/pathToTable/
<PARTITION_COLUMN_NAME>=<VALUE>/
<PARTITION_COLUMN_NAME>=<VALUE>/
<PARTITION_COLUMN_NAME>=<VALUE>/
... - Ví dụ thực tế:
s3://athena-examples/flight/parquet/year=1991/month=1/day=1/
- Cấu trúc thư mục ví dụ:
- Sử dụng file có kích thước lớn hơn (≥ 128 MB) để giảm overhead trong quá trình xử lý
Federated Query
- Cho phép bạn thực thi các truy vấn SQL trên dữ liệu được lưu trữ ở nhiều nguồn khác nhau, bao gồm:
- Cơ sở dữ liệu quan hệ (relational)
- Cơ sở dữ liệu phi quan hệ (non-relational)
- Dữ liệu dạng đối tượng (object)
- Nguồn dữ liệu tùy chỉnh (custom data sources)
→ Có thể nằm trên AWS hoặc on-premises
- Sử dụng Data Source Connectors chạy trên AWS Lambda để thực thi Federated Queries
→ Ví dụ: CloudWatch Logs, DynamoDB, RDS, ... - Kết quả truy vấn sẽ được lưu trở lại vào Amazon S3
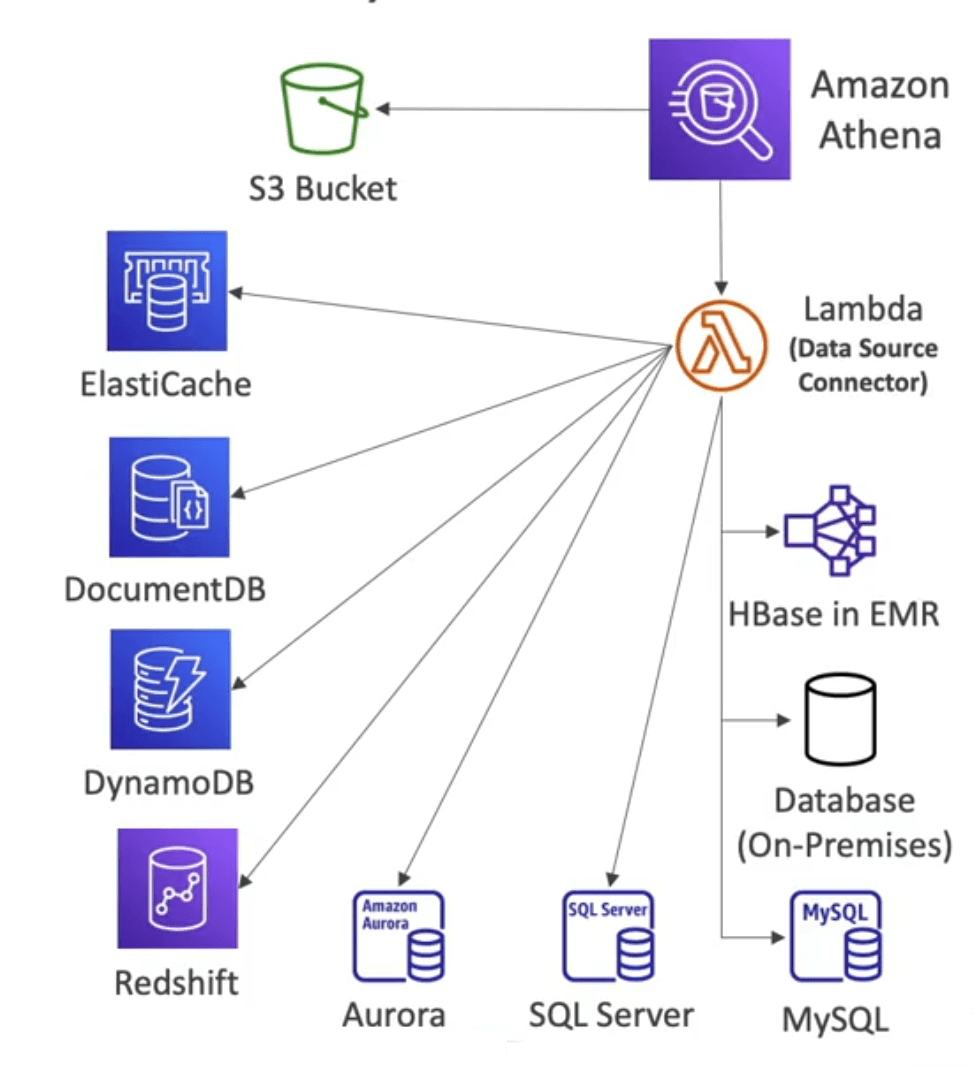
Giải thích chi tiết:
- Khi bạn chạy một câu lệnh SQL trong Athena (ví dụ:
SELECT * FROM dynamodb_table), Athena sẽ khởi tạo truy vấn đó. - Nhưng vì DynamoDB không phải là S3 (Athena chỉ đọc trực tiếp được từ S3), nên Athena sẽ:
- Gọi một AWS Lambda function tương ứng (do bạn hoặc AWS cung cấp trước) gọi là Data Source Connector
- Lambda kết nối tới DynamoDB, thực hiện truy vấn theo yêu cầu từ Athena, sau đó trả dữ liệu về cho Athena
- Athena tiếp tục xử lý phần còn lại của truy vấn (filter, join, aggregation, v.v.) như bình thường.
→ Athena chịu trách nhiệm chính trong việc thực thi truy vấn SQL, Lambda chỉ là cầu nối (connector) giúp Athena lấy dữ liệu từ các nguồn bên ngoài (không phải S3).
Bạn thấy bài này thế nào?