Redshift
Tổng quan về Redshift
- Redshift được xây dựng dựa trên PostgreSQL, nhưng không được sử dụng cho OLTP
- Đây là hệ thống OLAP – Online Analytical Processing (xử lý phân tích trực tuyến, dùng cho phân tích và lưu trữ dữ liệu).
- Hiệu năng cao hơn gấp 10 lần so với các data warehouse khác, có khả năng mở rộng tới đơn vị petabyte (PB).
- Lưu trữ dữ liệu theo cột (Columnar) thay vì theo dòng, kèm với engine truy vấn song song (parallel query engine).
- Tính phí theo mức sử dụng, dựa trên số lượng instance đã provision.
- Có giao diện SQL để thực hiện truy vấn.
- Các công cụ BI như Amazon Quicksight hoặc Tableau có thể tích hợp với Redshift.
- So với Athena: Redshift cho tốc độ truy vấn / join / tổng hợp nhanh hơn nhờ vào hệ thống chỉ mục (indexes).
Redshift Cluster
- Leader node: dùng để lập kế hoạch truy vấn (query planning), tổng hợp kết quả (results aggregation)
- Compute node: thực hiện các truy vấn, sau đó gửi kết quả về cho leader node
- Bạn cần provision trước kích thước của node
- Có thể sử dụng Reserved Instances để tiết kiệm chi phí
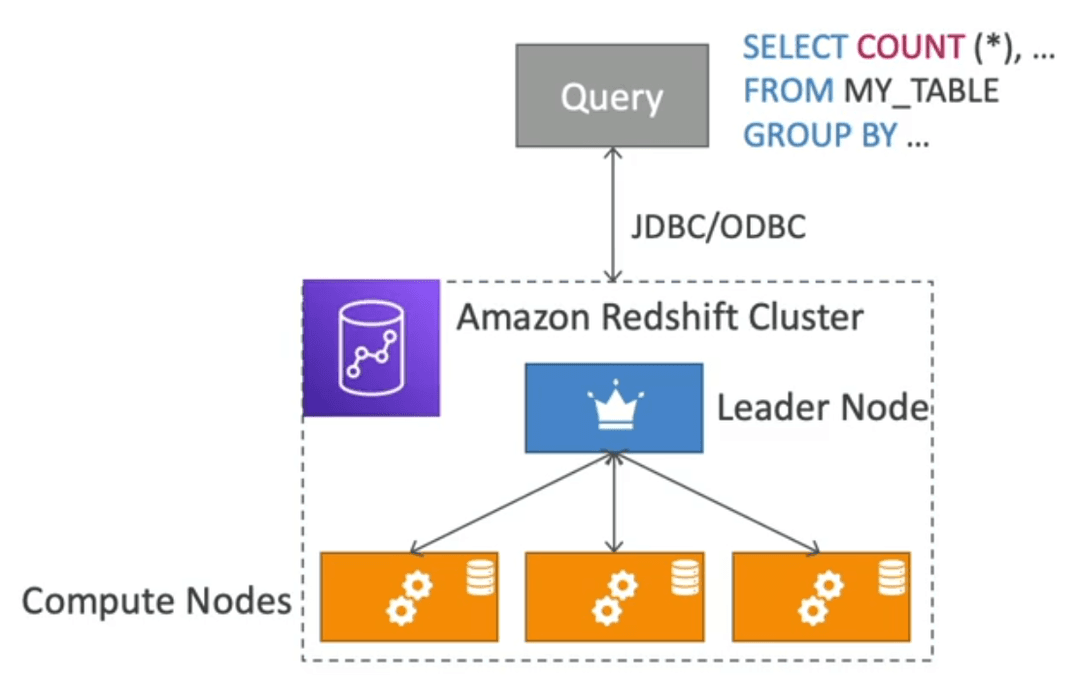
Giải thích sơ đồ
- Client gửi truy vấn SQL (ví dụ:
SELECT COUNT(*) FROM MY_TABLE GROUP BY ...) thông qua JDBC/ODBC driver đến Redshift Cluster. - Leader Node nhận truy vấn này, thực hiện parsing, lập kế hoạch thực thi (query plan) và phân phối các phần việc xuống các Compute Nodes.
- Compute Nodes thực thi các phần truy vấn được giao, xử lý dữ liệu và gửi lại kết quả trung gian về Leader Node.
- Leader Node sẽ tổng hợp các kết quả trung gian đó và trả về kết quả cuối cùng cho client.
Snapshots & DR (Disaster Recovery)
- Redshift hỗ trợ chế độ “Multi-AZ” cho một số cluster
- Snapshot là bản sao lưu tại thời điểm cụ thể (point-in-time backup) của một cluster, được lưu trữ nội bộ trong S3
- Snapshot là incremental – chỉ lưu phần dữ liệu có sự thay đổi kể từ snapshot trước
- Có thể restore snapshot thành một cluster mới
- Tự động: có thể thiết lập lịch chụp snapshot mỗi 8 tiếng, mỗi 5GB, hoặc theo lịch định sẵn, đồng thời cấu hình retention (thời gian giữ snapshot)
- Thủ công: snapshot được giữ cho tới khi bạn tự xoá
- Có thể cấu hình Amazon Redshift để tự động sao chép snapshot (tự động hoặc thủ công) từ một cluster sang AWS Region khác
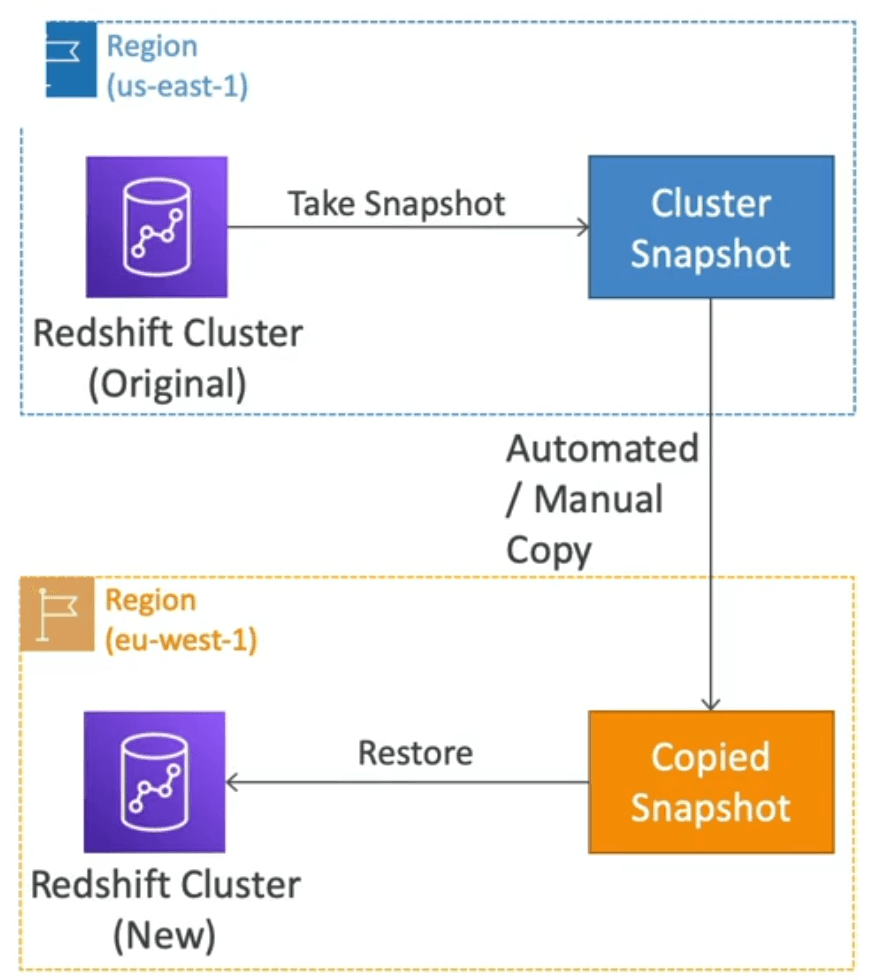
Giải thích sơ đồ
- Tại Region gốc (ví dụ
us-east-1), Redshift cluster thực hiện snapshot thủ công hoặc tự động. - Snapshot đó có thể được sao chép (automated/manual) sang region khác – ví dụ
eu-west-1. - Từ snapshot đã sao chép này, bạn có thể khôi phục thành một Redshift cluster mới ở region mới → hỗ trợ cho Disaster Recovery hoặc High Availability đa vùng.
Load dữ liệu vào Redshift
Amazon Kinesis Data Firehose
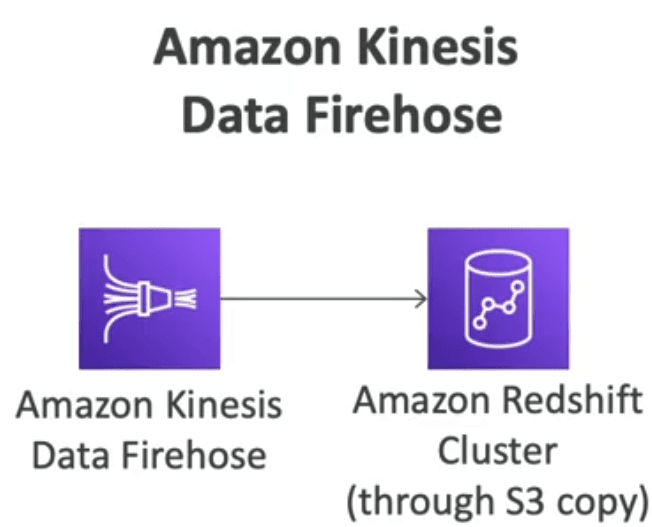
- Dữ liệu từ Kinesis Firehose có thể được tự động đẩy vào Redshift thông qua cơ chế copy từ S3.
- Đây là cách streaming data một cách realtime/near-realtime.
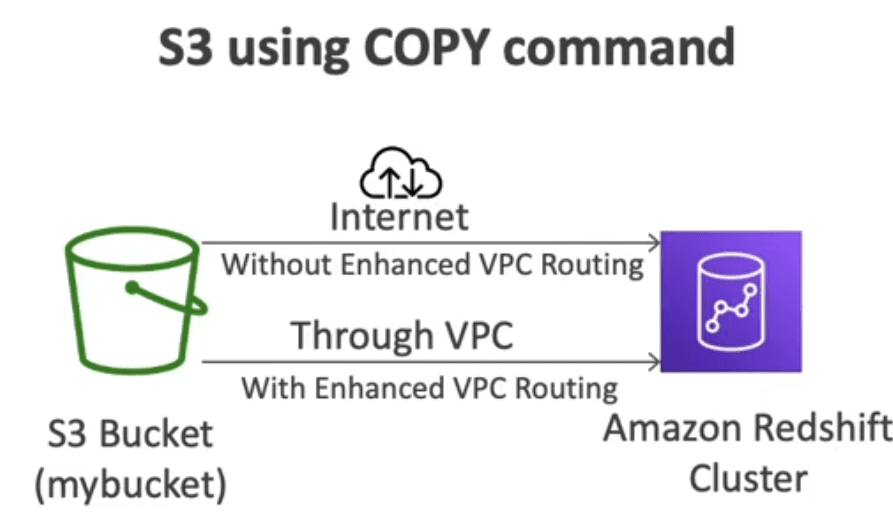
S3 using COPY command
- Sử dụng lệnh
COPYđể nạp dữ liệu hàng loạt từ S3 vào Redshift là cách tối ưu nhất để import dữ liệu lớn. - Có 2 kiểu route dữ liệu từ S3 đến Redshift:
- Qua Internet nếu không có VPC Routing
- Thông qua VPC (Enhanced VPC Routing) để tối ưu performance, bảo mật và cost.
copy customer
from 's3://mybucket/mydata'
iam_role 'arn:aws:iam::0123456789012:role/MyRedshiftRole';
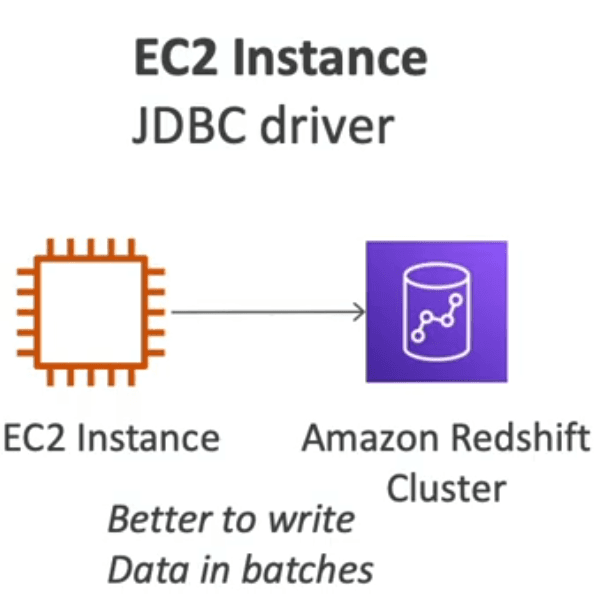
EC2 Instance sử dụng JDBC driver
- Trường hợp bạn sử dụng EC2 để insert dữ liệu vào Redshift (thông qua JDBC), cần lưu ý:
- Nên sử dụng batch insert thay vì insert từng row – sẽ giảm độ trễ và tải mạng.
Redshift Spectrum
- Cho phép bạn truy vấn dữ liệu trực tiếp từ S3 mà không cần load vào Redshift.
- Tuy nhiên, bắt buộc phải có một cụm Redshift đang hoạt động để khởi tạo truy vấn.
- Truy vấn sẽ được chuyển xuống các node xử lý thuộc Redshift Spectrum – một kiến trúc xử lý song song mạnh mẽ, có thể mở rộng đến hàng nghìn node.
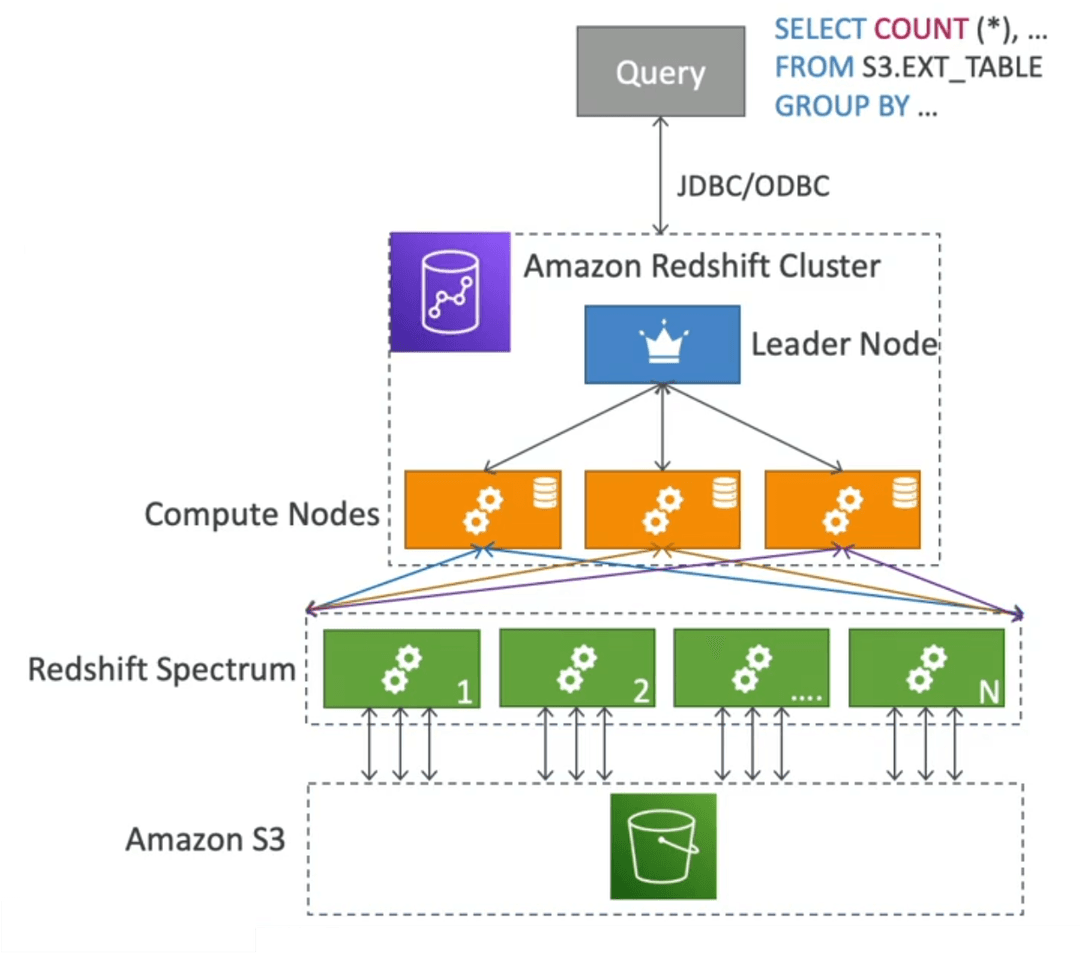
Giải thích sơ đồ
- Query layer
- Người dùng gửi truy vấn SQL qua kết nối JDBC/ODBC.
- Amazon Redshift Cluster
- Leader Node: nhận truy vấn, phân tích query plan.
- Compute Nodes: xử lý các phần truy vấn có thể thực thi trực tiếp, rồi điều phối gửi các phần cần Spectrum.
- Redshift Spectrum Nodes
- Các node ngoài cụm Redshift chính, chuyên xử lý dữ liệu external từ S3.
- Hoạt động song song, quy mô hàng nghìn node, giúp tăng performance vượt trội.
- Amazon S3
- Lưu trữ data gốc (ví dụ các file parquet, CSV...).
- Redshift Spectrum có thể đọc trực tiếp từ đây mà không cần import vào table Redshift truyền thống.
Bạn thấy bài này thế nào?