Glue
AWS Glue
- Dịch vụ ETL (Extract, Transform, Load) được quản lý.
- Dùng để chuẩn bị và chuyển đổi dữ liệu phục vụ phân tích.
- Dịch vụ hoàn toàn serverless.
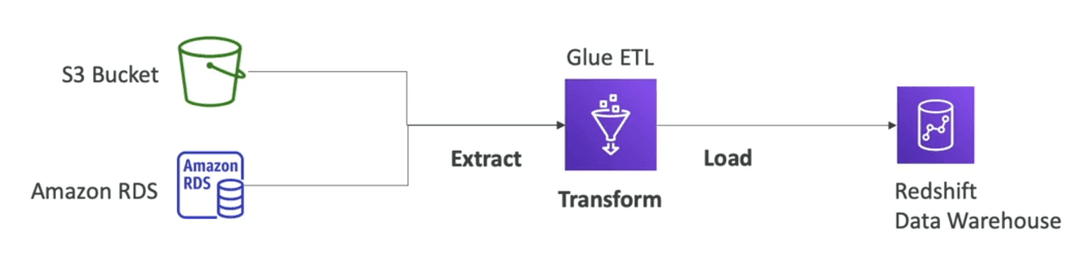
Giải thích sơ đồ:
- Nguồn dữ liệu đầu vào:
- S3 Bucket hoặc Amazon RDS
- Glue ETL:
- Extract: lấy dữ liệu từ nguồn
- Transform: xử lý, làm sạch, chuyển đổi cấu trúc dữ liệu
- Load: ghi dữ liệu đã xử lý vào kho lưu trữ đích
- Đích đến:
- Redshift Data Warehouse: nơi lưu trữ dữ liệu phân tích
Chuyển đổi dữ liệu sang định dạng Parquet
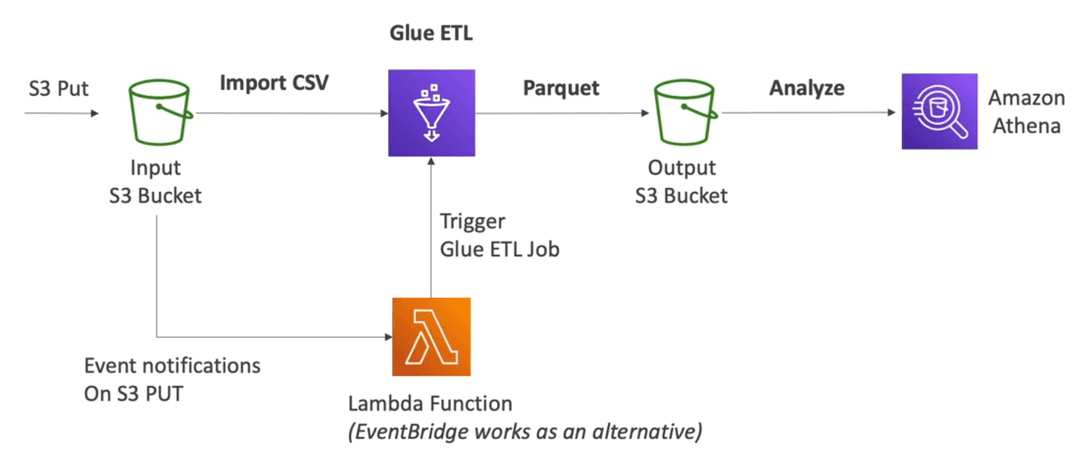
- Input S3 Bucket
- File CSV được import vào bucket thông qua thao tác
S3 Put.
- File CSV được import vào bucket thông qua thao tác
- Lambda Function
- Khi có event
PUTvào bucket (tức có file mới), Lambda function sẽ được kích hoạt. - Lambda này trigger job ETL của AWS Glue.
- Khi có event
- Glue ETL Job
- Job ETL đọc file CSV từ input bucket.
- Chuyển đổi dữ liệu sang định dạng Parquet.
- Ghi dữ liệu đã transform vào Output S3 Bucket.
- Amazon Athena
- Từ output bucket, Athena có thể đọc dữ liệu Parquet để thực hiện truy vấn phân tích dữ liệu (analyze).
Glue Data Catalog – Danh mục tập dữ liệu
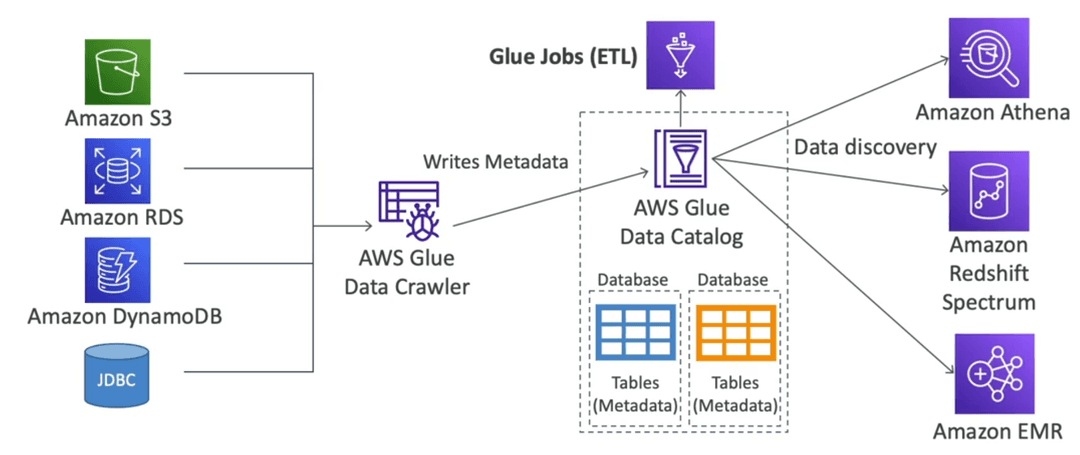
Luồng hoạt động:
- Nguồn dữ liệu:
- Amazon S3
- Amazon RDS
- Amazon DynamoDB
- ...
- AWS Glue Data Crawler:
- Tự động quét (crawl) dữ liệu từ các nguồn trên.
- Sinh metadata (thông tin schema, định nghĩa bảng, loại dữ liệu, etc.).
- Ghi metadata vào Glue Data Catalog.
- AWS Glue Data Catalog:
- Lưu trữ metadata dưới dạng các database và tables.
- Dùng như 1 centralized metadata store cho toàn bộ hệ thống analytics.
- Glue Jobs (ETL):
- ETL job đọc metadata từ Glue Catalog để transform và xử lý dữ liệu.
- Consumer sử dụng metadata từ Catalog:
- Amazon Athena: dùng để query trực tiếp dữ liệu trên S3 thông qua schema đã định nghĩa.
- Amazon Redshift Spectrum: truy vấn dữ liệu ngoài Redshift thông qua Glue Catalog.
- Amazon EMR: dùng metadata để process với Spark/Hive.
Glue – Những điều cần biết ở mức độ khái quát
- Glue Job Bookmarks: ngăn việc xử lý lại dữ liệu cũ
- Glue Elastic Views:
- Kết hợp và sao chép dữ liệu giữa nhiều kho dữ liệu khác nhau bằng cách sử dụng SQL
- Không cần viết mã tùy chỉnh, Glue sẽ theo dõi sự thay đổi trong dữ liệu nguồn, hoạt động theo mô hình serverless
- Tận dụng một “bảng ảo” (virtual table) – tức là materialized view
- Glue DataBrew: làm sạch và chuẩn hóa dữ liệu bằng cách sử dụng các phép biến đổi dựng sẵn (pre-built transformation)
- Glue Studio: giao diện GUI mới để tạo, chạy và giám sát các job ETL trong Glue
- Glue Streaming ETL (xây dựng trên Apache Spark Structured Streaming): tương thích với Kinesis Data Streaming, Kafka, MSK (Managed Kafka)
Bạn thấy bài này thế nào?