Amazon Aurora
Amazon Aurora
- Aurora là công nghệ độc quyền của AWS (không phải mã nguồn mở)
- Cả PostgreSQL và MySQL đều được hỗ trợ dưới dạng Aurora DB (tức là bạn có thể dùng driver PostgreSQL hoặc MySQL như bình thường). Nghĩa là Aurora hỗ trợ 2 "flavors" (biến thể):
- Aurora MySQL-Compatible Edition
- Aurora PostgreSQL-Compatible Edition
-> Bạn có thể migrate ứng dụng từ MySQL/PostgreSQL truyền thống sang Aurora mà không cần sửa code kết nối — miễn là bạn dùng các driver tương thích chuẩn.
Điều này giúp giảm chi phí migration và tăng khả năng tương thích cho ứng dụng.
- Aurora là hệ thống được "tối ưu hóa cho cloud của AWS" và tuyên bố đạt hiệu năng:
- cao hơn 5 lần so với MySQL trên RDS
- cao hơn 3 lần so với PostgreSQL trên RDS
- Aurora tự động mở rộng dung lượng lưu trữ theo từng bước 10GB, tối đa lên đến 128TB
- Aurora hỗ trợ lên tới 15 read replica và quá trình replication nhanh hơn MySQL (độ trễ < 10ms)
- Failover trong Aurora diễn ra tức thì, do được thiết kế native High Availability (HA)
- Aurora đắt hơn RDS (~20%), nhưng hiệu quả hơn nhiều
Cơ chế High Availability của Aurora
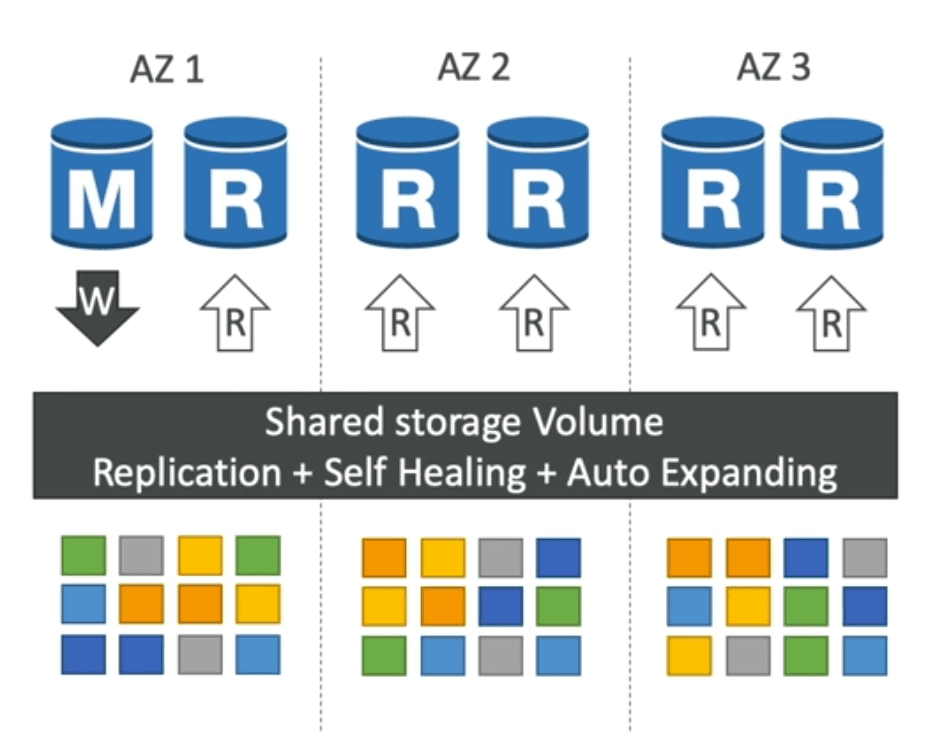
- 6 bản sao dữ liệu được phân phối trên 3 Availability Zone (AZ):
- Chỉ cần 4 trong 6 bản sao để thực hiện ghi (write).
- Aurora không cần chờ cả 6 bản sao ghi xong, điều đó sẽ rất chậm và dễ bị ảnh hưởng bởi network.
- Thay vào đó, chỉ cần 4 trong 6 bản sao xác nhận ghi thành công, thì thao tác write đó được xem là hoàn tất và thành công.
- Chỉ cần 3 trong 6 bản sao để thực hiện đọc (read).
- Khi đọc, hệ thống sẽ lấy dữ liệu từ ít nhất 3 bản sao, so sánh giá trị/timestamp/version, rồi lấy cái mới nhất và nhất quán nhất để trả về.
- Điều này làm giảm độ trễ đọc (latency) vì Aurora không cần truy vấn tất cả các bản sao.
- Tự phục hồi (Self-healing) thông qua cơ chế replication ngang hàng (peer-to-peer replication).
- Lưu trữ được phân mảnh (striped) trên hàng trăm volume để tối ưu hiệu năng và tính khả dụng.
- Tức là một cơ sở dữ liệu Aurora không lưu trên 1 ổ đĩa duy nhất, mà chia nhỏ dữ liệu thành nhiều mảnh nhỏ (data blocks), rồi lưu phân tán trên hàng trăm volume khác nhau (ở nhiều AZ).
- Chỉ một instance Aurora có quyền ghi (master).
- Tự động chuyển đổi dự phòng (failover) cho master chỉ trong vòng dưới 30 giây.
- Có thể cấu hình master + tối đa 15 Aurora Read Replica để phục vụ truy vấn đọc (read scaling).
- Hỗ trợ replication liên vùng (Cross-Region Replication) giữa các Region AWS khác nhau.
Aurora DB Cluster
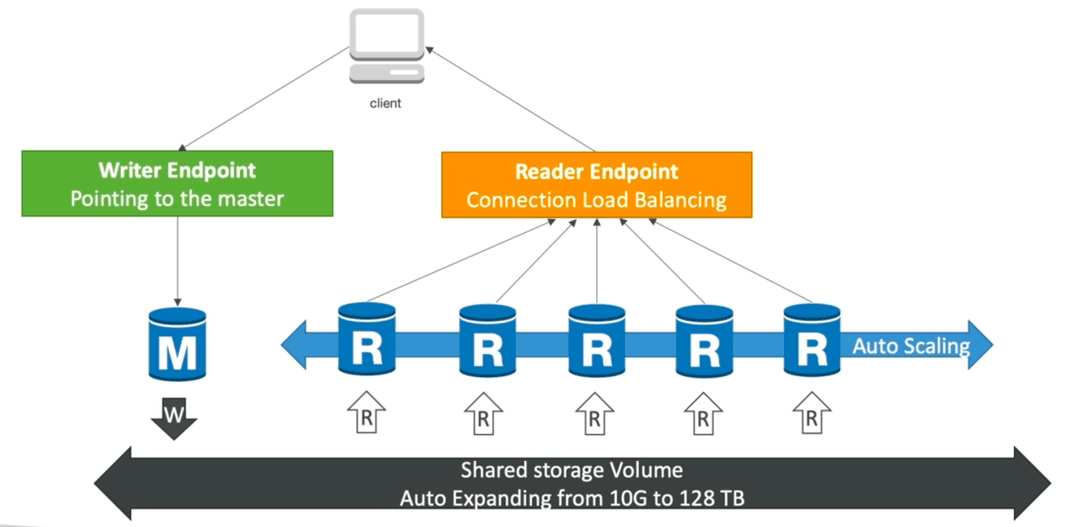
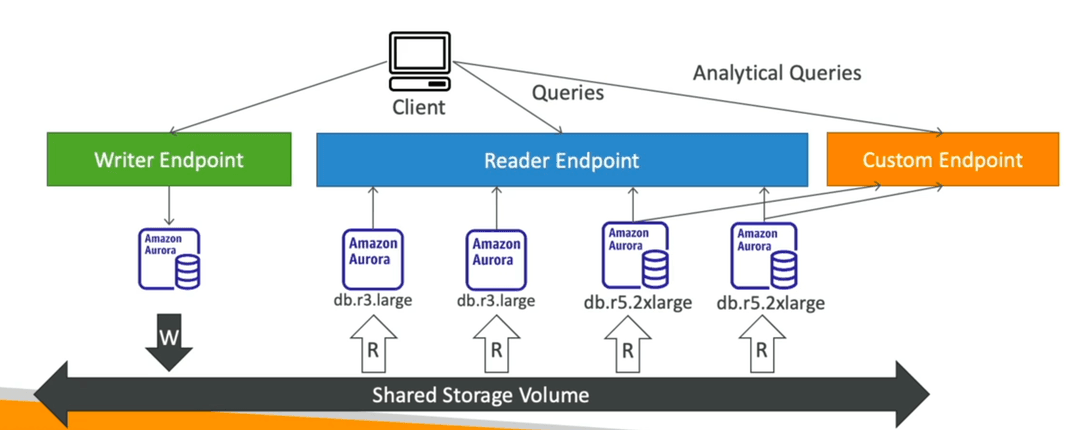
Là một thành phần cốt lõi của Amazon Aurora, dịch vụ cơ sở dữ liệu quan hệ do AWS cung cấp. Cụ thể, ảnh dưới minh họa mô hình kiến trúc Multi-AZ cluster của Aurora, trong đó có một node ghi (writer/master) và nhiều node đọc (reader/replica).
- Luồng ghi (Write flow):
- Client gửi truy vấn ghi đến Writer Endpoint, endpoint này luôn trỏ về Master Node (M) duy nhất.
- Node Master này chịu trách nhiệm xử lý tất cả các thao tác ghi dữ liệu và đồng bộ các thay đổi xuống bộ nhớ chia sẻ.
- Luồng đọc (Read flow):
- Client có thể gửi truy vấn đọc đến Reader Endpoint, nơi thực hiện Load Balancing (cân bằng tải) giữa nhiều Replica node (R).
- Các node Replica chỉ xử lý truy vấn đọc và không can thiệp vào dữ liệu ghi.
- Tính năng Auto Scaling:
- Aurora có khả năng tự động thêm các Replica node khi lưu lượng truy cập tăng cao, đảm bảo hiệu năng đọc.
- Kiến trúc lưu trữ chia sẻ (Shared Storage Architecture):
- Tất cả các node (Writer và Reader) dùng chung một khối lưu trữ (Shared Storage Volume).
Replica auto scaling
- Là tính năng tự động tăng/giảm số lượng Reader instance trong Aurora Cluster dựa trên các chỉ số tải (CPU, kết nối, throughput, v.v.)
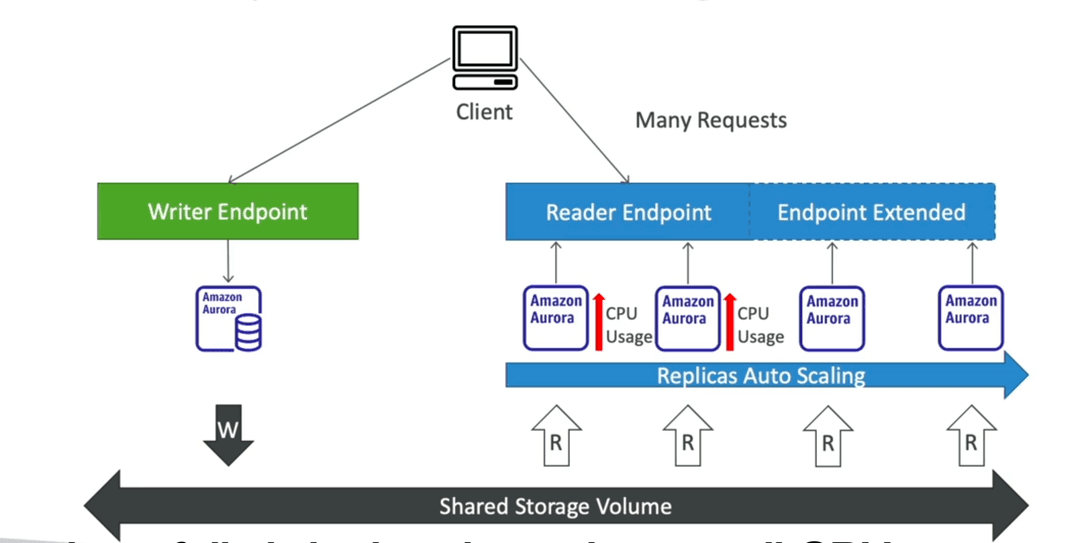
- Khi client gửi nhiều truy vấn đọc đến
Reader Endpoint, Aurora sẽ theo dõi:- CPU Usage tăng cao
- Số lượng kết nối nhiều
- Aurora sẽ tự động scale-out thêm các replica instance (biểu tượng “Endpoint Extended”) để cân bằng tải.
- Các replica này vẫn thuộc cùng một Aurora Cluster, chỉ là được tự động scale chứ không tạo thủ công.
Custom Endpoints
- Cho phép bạn gán một tập con cụ thể các replica instances vào một endpoint riêng biệt.
- Client sẽ gửi các truy vấn cụ thể (VD: analytical queries) đến endpoint này.
- Nhờ đó, không gây ảnh hưởng hiệu năng lên các replica còn lại (đang xử lý các truy vấn production-critical).
Aurora Serverless
- Khởi tạo cơ sở dữ liệu tự động và tự động scale dựa trên mức sử dụng thực tế
- Phù hợp với khối lượng công việc không thường xuyên, gián đoạn hoặc khó đoán trước
- Không cần lập kế hoạch công suất (capacity planning)
- Tính phí theo giây, có thể tiết kiệm chi phí hơn
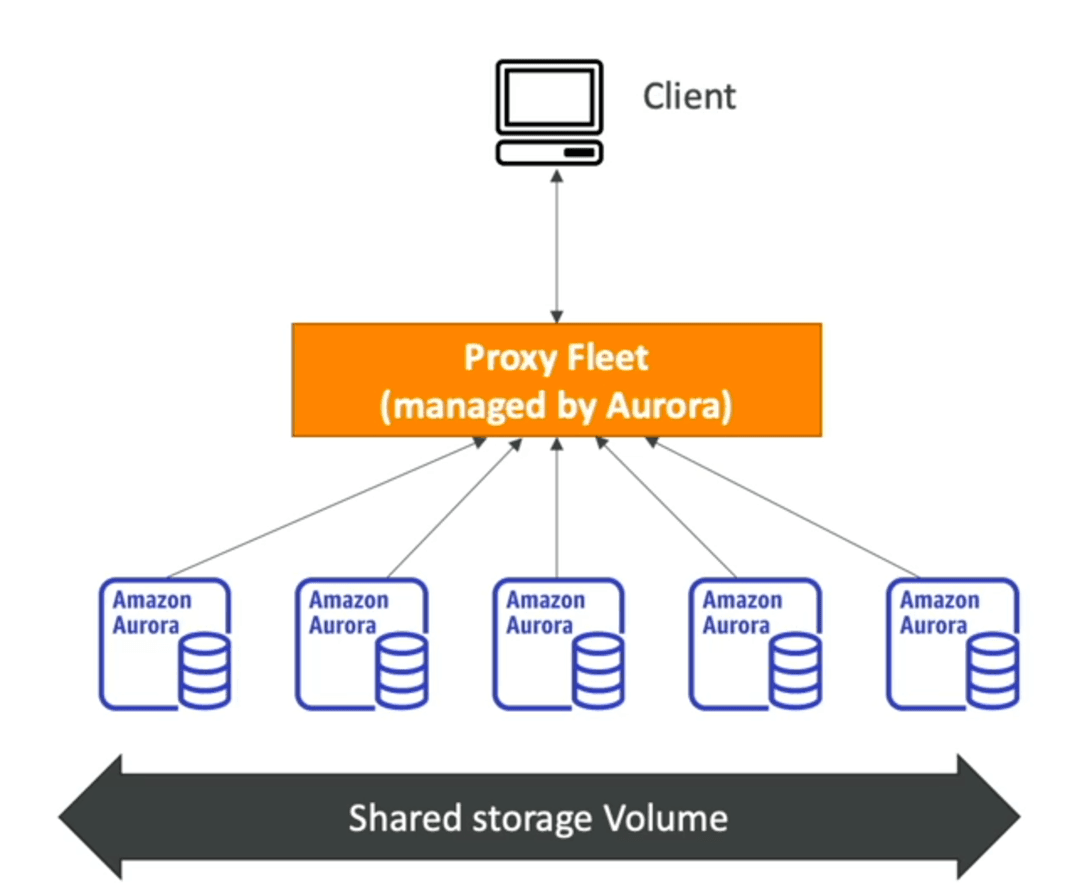
- Client: App hoặc service của bạn gửi truy vấn đến hệ thống Aurora.
- Proxy Fleet (managed by Aurora): Aurora đứng ra vận hành một cụm proxy trung gian, tiếp nhận kết nối từ client, sau đó phân phối truy vấn đến các instance phía sau.
- Các Amazon Aurora instances phía sau là các node xử lý thật (có thể sinh ra/tắt đi tùy theo tải thực tế).
- Shared Storage Volume: Tất cả instances này truy cập chung một storage backend, đảm bảo dữ liệu đồng nhất.
Aurora Serverless v2 & Aurora Provisioned + Replica Auto Scaling
| Đặc điểm | Aurora Serverless v2 | Aurora Provisioned + Replica Auto Scaling |
|---|---|---|
| Loại Instance | Compute instance dynamically created | Instance được add/remove thủ công hoặc auto-scaling |
| Proxy Layer | Có Proxy Fleet (do Aurora quản lý) | Không có proxy trung gian — app kết nối trực tiếp endpoint |
| Kết nối ứng dụng | Không gián đoạn, kết nối qua proxy | Có thể gián đoạn nếu scale hoặc failover |
| Khả năng Scale | Scale theo CPU/RAM, cực kỳ mịn (granular, per fraction vCPU) | Scale theo số lượng replicas, thường theo CPU hoặc lag |
| Dừng hoàn toàn khi idle | Có thể tạm dừng hoàn toàn compute, không mất dữ liệu | Không thể — replica vẫn hoạt động |
| Thanh toán | Tính theo giây, dựa vào usage (ACUs) | Trả tiền theo giờ cho mỗi replica |
| Dùng cho workload nào? | Phù hợp workload biến động, không thường xuyên | Phù hợp workload ổn định, cần high throughput hoặc HA |
| Custom endpoint (ví dụ analytic) | Không áp dụng — proxy handle routing ngầm | Có thể tạo custom endpoint để phân loại replica |
Load Balancing trong Provisioned vs Proxy Fleet trong Serverless
| Tiêu chí | Aurora Provisioned (Reader Endpoint) | Aurora Serverless (Proxy Fleet) |
|---|---|---|
| Cách hoạt động | DNS-based load balancing (round-robin / failover) | Connection-aware load balancing (smart proxy) |
| Ai chịu trách nhiệm route? | Client-side DNS resolver | Aurora-managed proxy fleet (trung gian thực thụ) |
| Cấp độ kiểm soát connection | Không — client dùng reader endpoint, Aurora phân theo DNS | Proxy giữ persistent connection, tối ưu tự động |
| Thời điểm route | Tại thời điểm DNS resolve | Runtime, Aurora có thể redirect truy vấn động |
| Có connection pool? | ❌ Client tự quản lý | ✅ Aurora quản lý pool centralized qua proxy |
| Tự động failover truy vấn đang chạy | ❌ Phụ thuộc vào client và reconnect | ✅ Proxy Fleet có thể xử lý failover mượt hơn |
| Tối ưu hóa latency, load, scaling | ❌ Rất hạn chế, static | ✅ Có thể route theo CPU usage, scaling real-time |
| Cần setup thêm không? | Không, dùng reader endpoint | Không — proxy fleet là mặc định trong serverless |
Global Aurora
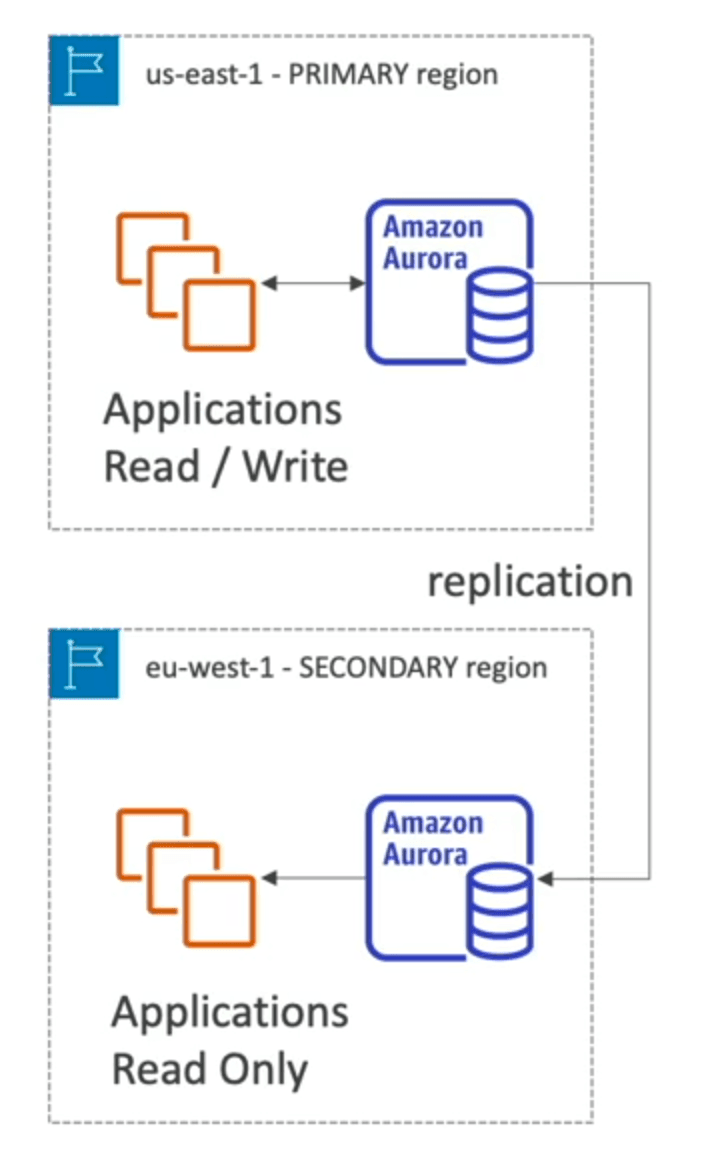
- Aurora Cross-Region Read Replicas:
- Hữu ích cho disaster recovery
- Triển khai đơn giản
- Aurora Global Database
- 1 Primary Region: hỗ trợ đọc/ghi
- Tối đa 5 Secondary Regions dạng chỉ đọc, độ trễ sao chép nhỏ hơn 1 giây
- Hỗ trợ tối đa 16 Read Replica cho mỗi Secondary Region
- Hữu ích trong việc giảm độ trễ truy cập
- Có thể chuyển Secondary Region thành Primary Region trong tình huống DR (disaster recovery), với RTO < 1 phút
- Thời gian sao chép dữ liệu giữa các vùng thường nhỏ hơn 1 giây
Aurora Database Cloning
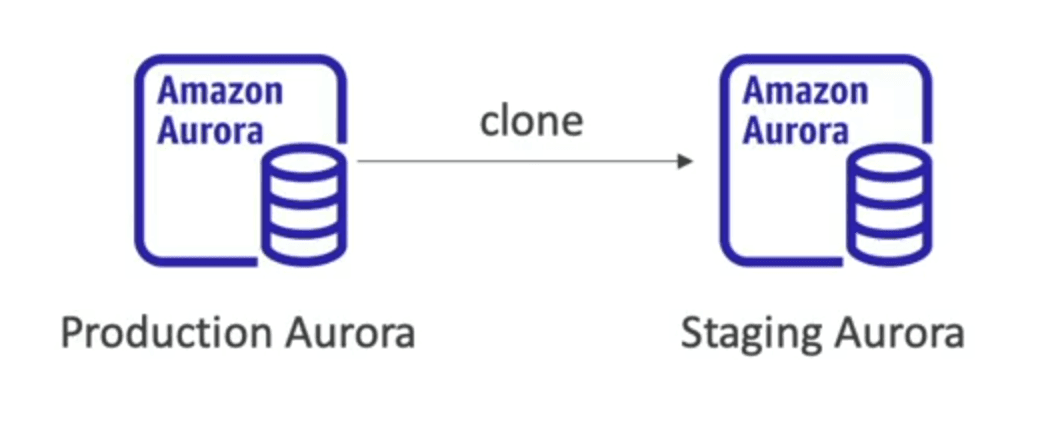
- Tạo một Aurora DB Cluster mới từ một Cluster đã có sẵn
- Nhanh hơn so với phương pháp snapshot & restore
- Sử dụng giao thức copy-on-write
- Ban đầu, cụm CSDL mới sử dụng cùng volume dữ liệu với cụm CSDL gốc (rất nhanh và hiệu quả – không cần copy)
- Khi dữ liệu trong cụm mới có thay đổi, hệ thống sẽ cấp phát thêm storage và copy dữ liệu được sửa đổi sang vùng lưu trữ riêng biệt
- Rất nhanh và tiết kiệm chi phí
- Hữu ích để tạo ra một CSDL môi trường staging từ CSDL production mà không ảnh hưởng đến production
Các tính năng của Aurora
- Automatic fail-over
→ Tự động chuyển đổi node khi có sự cố (failover) xảy ra, đảm bảo tính sẵn sàng cao. - Backup and Recovery
→ Sao lưu và phục hồi dữ liệu tự động, không cần can thiệp thủ công. - Isolation and security
→ Cô lập và bảo mật: hỗ trợ VPC, IAM, KMS encryption... giúp kiểm soát truy cập và mã hóa dữ liệu. - Industry compliance
→ Đáp ứng các tiêu chuẩn bảo mật và tuân thủ trong ngành (ví dụ: PCI DSS, HIPAA, SOC 1/2/3...). - Push-button scaling
→ Mở rộng tài nguyên (compute) chỉ với thao tác đơn giản, không downtime. - Automated Patching with Zero Downtime
→ Tự động cập nhật bản vá hệ thống mà không gây gián đoạn dịch vụ. - Advanced Monitoring
→ Tích hợp giám sát nâng cao qua Amazon CloudWatch, Performance Insights. - Routine Maintenance
→ Bảo trì định kỳ có thể cấu hình thời gian để giảm thiểu tác động đến hệ thống. - Backtrack: restore data at any point of time without using backups
→ Backtrack: hoàn tác dữ liệu về thời điểm bất kỳ mà không cần dùng bản sao lưu, hoạt động tương tự như undo log (áp dụng với Aurora MySQL).
Bạn thấy bài này thế nào?