Dynamo DB
- Luôn sẵn sàng với khả năng replication giữa nhiều Availability Zones (AZs)
- Cơ sở dữ liệu NoSQL – không phải cơ sở dữ liệu quan hệ – có hỗ trợ transaction
- Khả năng mở rộng tới khối lượng công việc rất lớn, là cơ sở dữ liệu phân tán
- Xử lý hàng triệu request mỗi giây, hàng nghìn tỷ dòng dữ liệu, hàng trăm TB dung lượng lưu trữ
- Hiệu năng nhanh và ổn định (độ trễ chỉ vài mili-giây)
- Tích hợp với IAM cho các chức năng bảo mật, phân quyền và quản trị
- Chi phí thấp và có khả năng auto-scaling
- Không cần bảo trì hay vá lỗi, luôn availale
- Hỗ trợ 2 loại lớp bảng: Standard và Infrequent Access (IA Table Class – dùng cho dữ liệu truy cập không thường xuyên)
Tổng quan
- DynamoDB được cấu thành từ các Table (bảng)
- Mỗi bảng phải có một Primary Key (phải được xác định tại thời điểm tạo bảng)
- Mỗi bảng có thể chứa số lượng item (dòng) không giới hạn
- Mỗi item có các attribute (thuộc tính) – các thuộc tính này có thể thêm dần theo thời gian và có thể null
- Kích thước tối đa của một item là 400KB
- Các kiểu dữ liệu được hỗ trợ bao gồm:
- Scalar Types:
String,Number,Binary,Boolean,Null - Document Types:
List,Map - Set Types:
String Set,Number Set,Binary Set
- Scalar Types:
👉 Do đó, trong DynamoDB, bạn có thể phát triển schema một cách linh hoạt và nhanh chóng
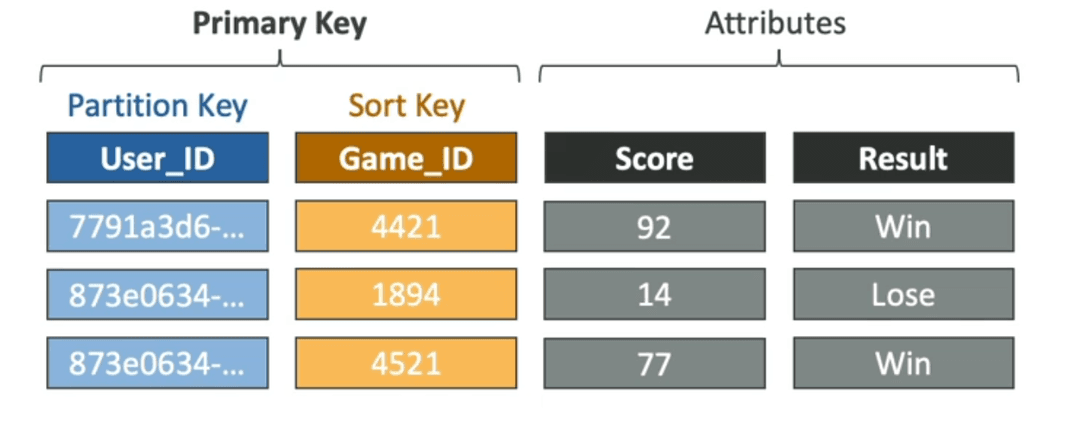
Sơ đồ biểu diễn một bảng DynamoDB có:
- Partition Key:
User_ID - Sort Key:
Game_ID
=> Đây gọi là Composite Primary Key (Khóa chính tổng hợp)
📊 Giải thích từng thành phần
| Thành phần | Giải thích |
|---|---|
| Partition Key (User_ID) | Được dùng để phân chia dữ liệu (partitioning) — tất cả các bản ghi có cùng giá trị User_ID sẽ được lưu trong cùng một partition. |
| Sort Key (Game_ID) | Dữ liệu trong cùng một partition (cùng User_ID) sẽ được sắp xếp theo Game_ID, cho phép truy vấn theo kiểu: "Lấy toàn bộ game của user X, sắp xếp theo ID" hoặc lọc theo range (BETWEEN, >, <,...). |
| Attributes | Bao gồm các cột khác như Score và Result, là các thuộc tính tùy ý, có thể thay đổi và không cần khai báo trước (schema-less). |
Read/Write Capacity Modes
Kiểm soát cách bạn quản lý dung lượng throughput đọc/ghi của bảng DynamoDB
Provisioned Mode (Chế độ cấu hình trước - mặc định)
- Bạn chỉ định rõ số lượng lần đọc/ghi mỗi giây.
- Cần lập kế hoạch dung lượng từ trước (capacity planning).
- Tính phí dựa trên:
RCU– Read Capacity Unit (Đơn vị dung lượng đọc)WCU– Write Capacity Unit (Đơn vị dung lượng ghi)
- Có thể kích hoạt chế độ tự động scale (
auto-scaling) cho cảRCUvàWCU.
Note
Thích hợp cho hệ thống có lưu lượng ổn định, dễ dự đoán. Nếu vượt quá số lượng cấu hình sẵn, bạn sẽ bị throttling.
On-Demand Mode (Chế độ theo nhu cầu)
- Hệ thống tự động scale up/down đọc/ghi dựa theo workload thực tế.
- Không cần lập kế hoạch dung lượng.
- Trả tiền theo mức sử dụng thực tế, nhưng chi phí sẽ cao hơn đáng kể nếu lưu lượng lớn hoặc đột biến.
- Chi phí khó dự đoán khi có burst traffic
Note
Phù hợp cho các hệ thống mới build, chưa rõ lưu lượng, hoặc các hệ thống có traffic bất thường (ví dụ: sự kiện tăng đột biến, app flash-sale).
DynamoDB – Time To Live (TTL)
- TTL (Time To Live) là cơ chế cho phép định nghĩa một thời điểm (epoch timestamp) mà sau đó DynamoDB sẽ tự động xóa item ra khỏi bảng.
- Cách hoạt động:
- Bạn khai báo một TTL attribute cho bảng, ví dụ
ExpTime. - DynamoDB sẽ background scan định kỳ.
- Nếu giá trị của TTL nhỏ hơn thời gian hiện tại (
current epoch time) → item đó sẽ được đưa vào hàng chờ xóa. - Xóa không xảy ra ngay lập tức, nhưng sẽ được thực hiện định kỳ.
- Bạn khai báo một TTL attribute cho bảng, ví dụ
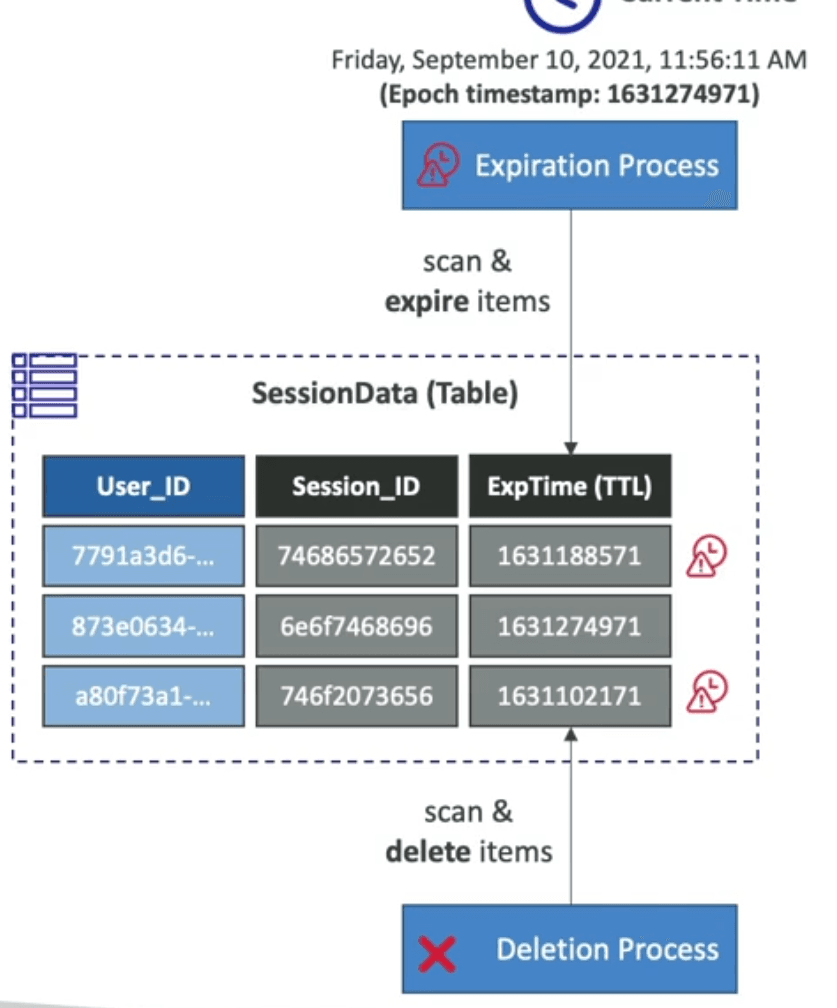
- Tự động xóa các item sau khi vượt quá thời điểm hết hạn (timestamp).
- Trường hợp sử dụng: giảm dữ liệu lưu trữ bằng cách chỉ giữ lại item hiện tại, tuân thủ yêu cầu pháp lý, quản lý session web,…
DynamoDB – Sao lưu phục vụ khôi phục sau thảm họa
- Sao lưu liên tục sử dụng tính năng khôi phục theo thời điểm (Point-in-time recovery - PITR)
- Có thể bật để lưu dữ liệu liên tục trong tối đa 35 ngày gần nhất kể từ thời điểm hiện tạ
- Có thể khôi phục dữ liệu (restore) tại bất kỳ thời điểm nào trong khoảng thời gian sao lưu
- Quá trình khôi phục (restore) sẽ tạo ra một bảng mới
- Sao lưu theo yêu cầu (On-demand backups)
- Sao lưu toàn bộ để lưu trữ dài hạn, cho đến khi bị xóa rõ ràng
- Không ảnh hưởng đến hiệu năng hoặc độ trễ của hệ thống
- Có thể cấu hình và quản lý thông qua AWS Backup (cho phép sao chép giữa các vùng - cross-region copy)
- Quá trình khôi phục cũng tạo ra một bảng mới
DynamoDB – Tích hợp với Amazon S3
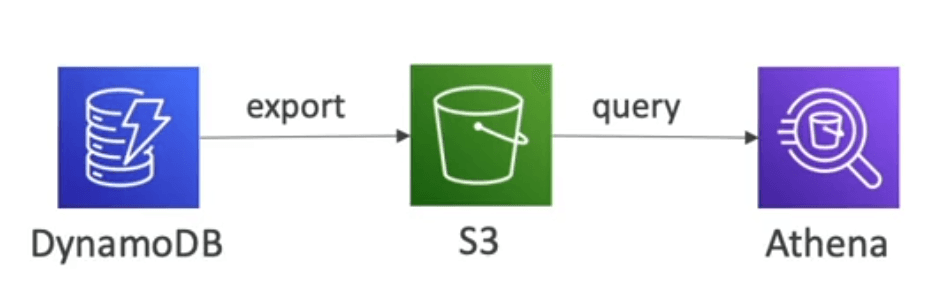
Export sang S3 (bắt buộc phải bật PITR)
- Hoạt động với bất kỳ thời điểm nào trong 35 ngày gần nhất (kể từ khi bật PITR)
- Không ảnh hưởng đến Read Capacity của bảng DynamoDB
- Cho phép phân tích dữ liệu từ snapshot của DynamoDB (ví dụ dùng Amazon Athena - Amazon Athena query trực tiếp lên dữ liệu trong S3 bằng cú pháp SQL)
- Lưu trữ snapshot (export dữ liệu DynamoDB ra S3 tại một thời điểm cụ thể) dùng để kiểm tra, đối chiếu, hoặc truy vết sau này.
- Có thể ETL (Extract – Transform – Load) dữ liệu trong S3 trước khi nhập trở lại DynamoDB
- Sau khi bạn export dữ liệu từ DynamoDB ra S3, bạn có thể:
- Extract (Trích xuất) dữ liệu từ file JSON/ION/CSV trong S3
- Transform (Chuyển đổi) – làm sạch, xử lý, biến đổi dữ liệu (ví dụ: đổi format, chuẩn hóa key, lọc bớt field, group by, map lại schema,...)
- Load (Tải vào) lại DynamoDB — thường là vào một bảng mới.
- Sau khi bạn export dữ liệu từ DynamoDB ra S3, bạn có thể:
- Hỗ trợ định dạng xuất:
DynamoDB JSONhoặcION
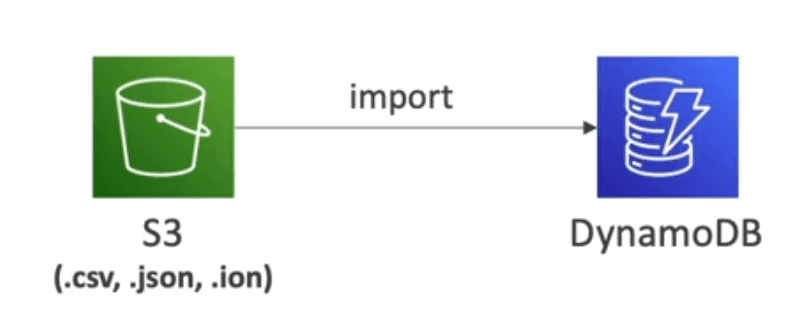
Import từ S3
- Nhập dữ liệu từ các định dạng: CSV, DynamoDB JSON, hoặc ION
- Không tiêu tốn Write Capacity khi import
- Tạo ra một bảng DynamoDB mới
- Lỗi import được log trong CloudWatch Logs
Bạn thấy bài này thế nào?