Lifecycle Rules - Requester Pays - Event Notifications
Di chuyển giữa các Storage Class
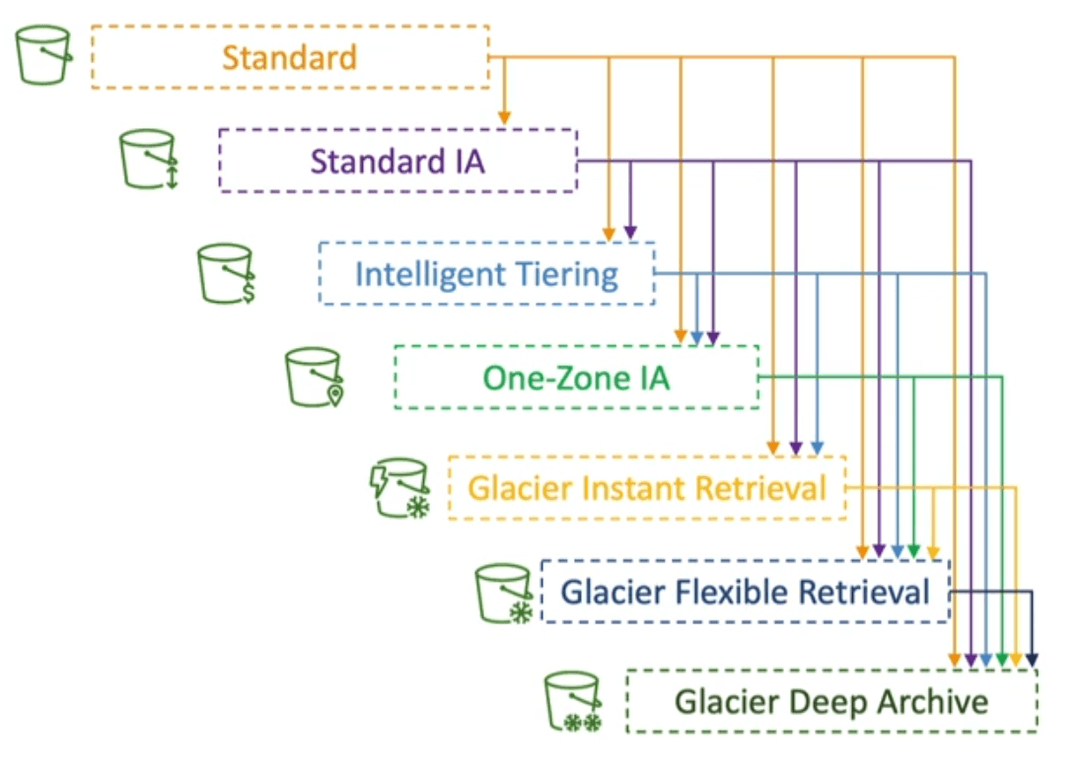
- Bạn có thể chuyển object giữa các lớp lưu trữ (storage classes).
- Với các object truy cập không thường xuyên, hãy chuyển sang Standard IA (Infrequent Access).
- Với các object dạng lưu trữ lâu dài, không yêu cầu truy cập nhanh, hãy chuyển chúng sang Glacier hoặc Glacier Deep Archive.
- Việc di chuyển các object có thể được tự động hóa bằng cách sử dụng Lifecycle Rules
Lifecycle Rules
- Transition Actions – cấu hình để các object được chuyển sang storage class khác
- Move current versions of objects between storage classes: Di chuyển các object hiện tại (phiên bản đang active) giữa các lớp lưu trữ khác nhau, ví dụ: từ
STANDARDsangSTANDARD_IA,GLACIER, v.v. - Move noncurrent versions of objects between storage classes: Di chuyển các phiên bản không còn là phiên bản hiện tại (noncurrent versions – ví dụ sau khi bật versioning thì object cũ được giữ lại khi có object mới ghi đè).
- Move current versions of objects between storage classes: Di chuyển các object hiện tại (phiên bản đang active) giữa các lớp lưu trữ khác nhau, ví dụ: từ
- Expiration Actions – cấu hình để các object tự động xóa sau một thời gian:
- Expire current versions of objects: Tự động xóa các object hiện tại sau một thời gian định sẵn (expire/delete).
- Permanently delete noncurrent versions of objects: Xóa vĩnh viễn các phiên bản không còn là current.
- Delete expired object delete markers or incomplete multipart uploads
- Xóa delete marker đã hết hạn: khi object bị delete nhưng bucket có versioning, delete marker được tạo — mục này sẽ xóa marker đó sau thời gian expire.
- Xóa các phần upload chưa hoàn tất (multipart): cleanup các file bị gián đoạn khi upload.
- Rule có thể được tạo dựa theo:
- Prefix (tiền tố), ví dụ:
s3://mybucket/mp3/* - Tag của object, ví dụ:
Department: Finance
- Prefix (tiền tố), ví dụ:
Tình huống 1:
- Ứng dụng của bạn trên EC2 tạo ảnh thumbnail sau khi ảnh đại diện (profile photos) được upload lên Amazon S3. Các thumbnail này có thể dễ dàng được tái tạo, và chỉ cần giữ lại trong 60 ngày. Các ảnh gốc cần có khả năng truy xuất tức thời trong 60 ngày, Sau đó, người dùng có thể chờ đến 6 giờ nếu cần truy xuất lại. Bạn sẽ thiết kế như thế nào?
- Giải pháp thiết kế:
- Ảnh gốc lưu trữ trên lớp Standard, sau đó chuyển sang Glacier sau 60 ngày thông qua cấu hình lifecycle rule.
→ Glacier là hợp lý vì sau 60 ngày, việc truy xuất có thể delay (Glacier retrieval time lên đến vài giờ). - Ảnh thumbnail có thể lưu trên One-Zone IA để tiết kiệm chi phí, và cấu hình để xóa sau 60 ngày bằng Expiration rule.
→ Do ảnh thumbnail có thể được tái tạo, việc xóa hoàn toàn là chấp nhận được.
- Ảnh gốc lưu trữ trên lớp Standard, sau đó chuyển sang Glacier sau 60 ngày thông qua cấu hình lifecycle rule.
Tình huống 2:
- Một quy định trong công ty bạn yêu cầu rằng: Các object S3 bị xóa cần phải khôi phục được ngay lập tức trong vòng 30 ngày (dù trường hợp này hiếm xảy ra). Sau 30 ngày và tối đa trong 365 ngày, object bị xóa vẫn phải có khả năng khôi phục trong vòng 48 giờ.
- Giải pháp thiết kế:
- Bật tính năng S3 Versioning để lưu trữ nhiều phiên bản object.
Khi xóa một object, nó không bị xóa thật sự mà chỉ bị ẩn bởi một "delete marker", nên hoàn toàn có thể khôi phục được. - Transition các "noncurrent versions" (các phiên bản cũ không phải phiên bản hiện tại):
- Sau 30 ngày → chuyển sang lớp lưu trữ Standard-IA (truy xuất chậm, chi phí rẻ).
- Sau một khoảng thời gian tiếp theo (ví dụ sau 90 ngày) → chuyển tiếp sang Glacier Deep Archive (chi phí lưu trữ cực thấp, nhưng thời gian truy xuất lên đến 12–48 giờ).
- Bật tính năng S3 Versioning để lưu trữ nhiều phiên bản object.
Storage Class Analysis
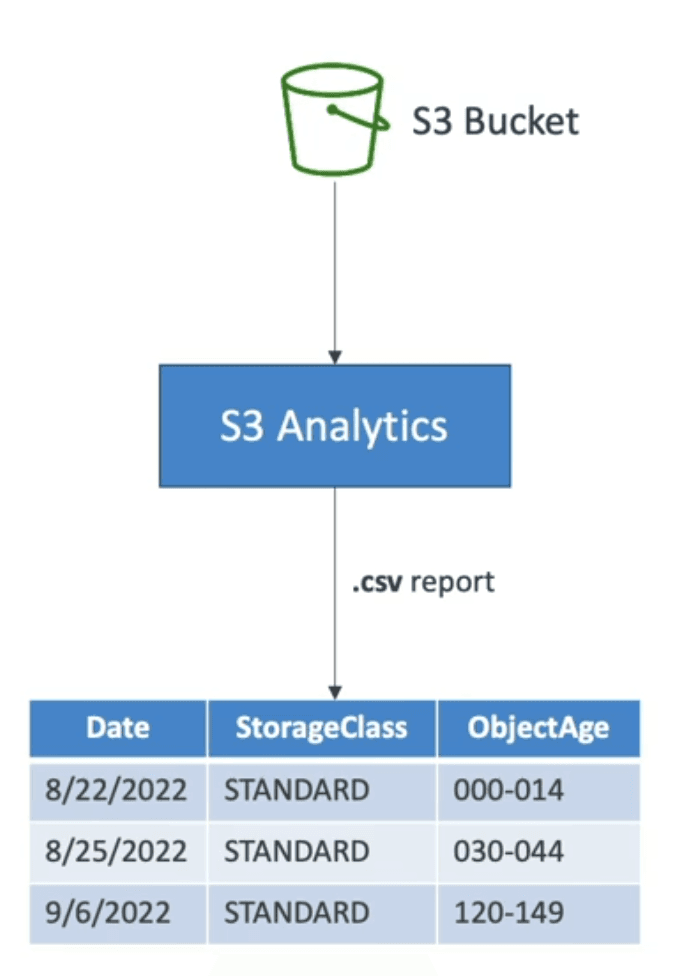
- Chức năng chính:
- Giúp bạn quyết định khi nào nên chuyển object sang lớp lưu trữ phù hợp (ví dụ từ Standard sang Standard-IA).
- Lưu ý kỹ thuật:
- Chỉ cung cấp gợi ý chuyển đổi cho lớp Standard và Standard-IA.
- ❌ Không hỗ trợ One-Zone IA hoặc Glacier.
- Thông tin thêm:
- Báo cáo được cập nhật hàng ngày.
- Mất 24–48 giờ để bắt đầu thấy phân tích dữ liệu.
- Dữ liệu phân tích được export dưới dạng file
.csv.
Requester Pays
Standard Bucket
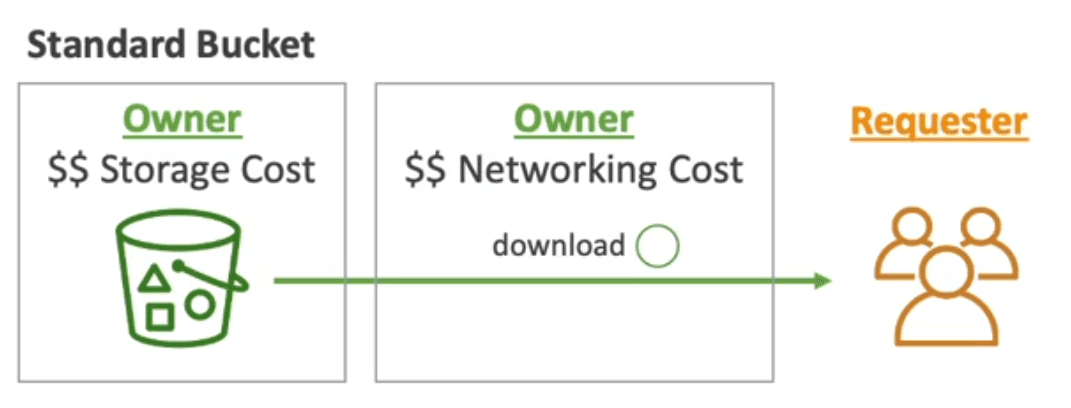
- Owner (người sở hữu bucket) sẽ chịu toàn bộ chi phí, bao gồm:
- Storage Cost: phí lưu trữ object trong bucket.
- Networking Cost: phí truyền tải dữ liệu khi có người tải dữ liệu từ bucket.
👉 Điều này không tối ưu nếu bạn muốn chia sẻ tập dữ liệu lớn công khai (vd: dữ liệu nghiên cứu, hình ảnh vệ tinh...), vì bạn sẽ phải gánh mọi chi phí truyền tải.
Requester Pays Bucket
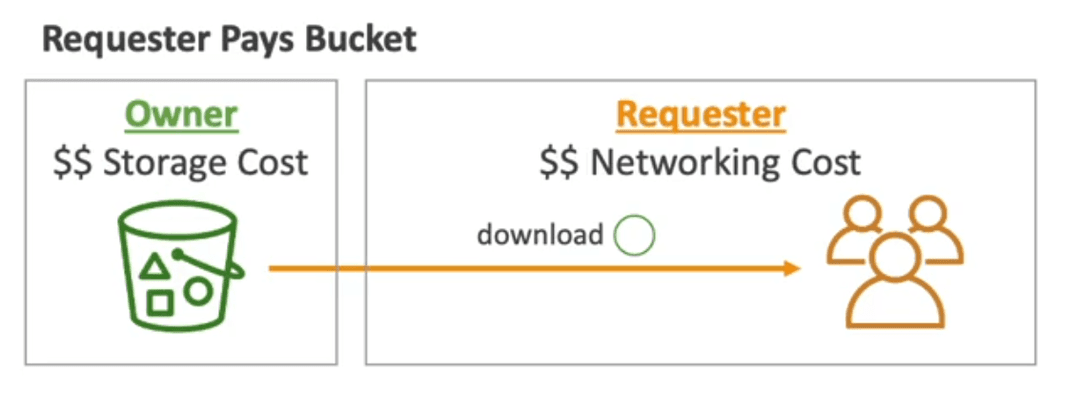
- Storage Cost vẫn do owner chịu (chi phí lưu trữ object).
- Networking Cost (download data, API call...) sẽ do requester trả tiền.
📌 Requester phải:
- Có AWS account hợp lệ.
- Được xác thực (authenticated), không được anonymous.
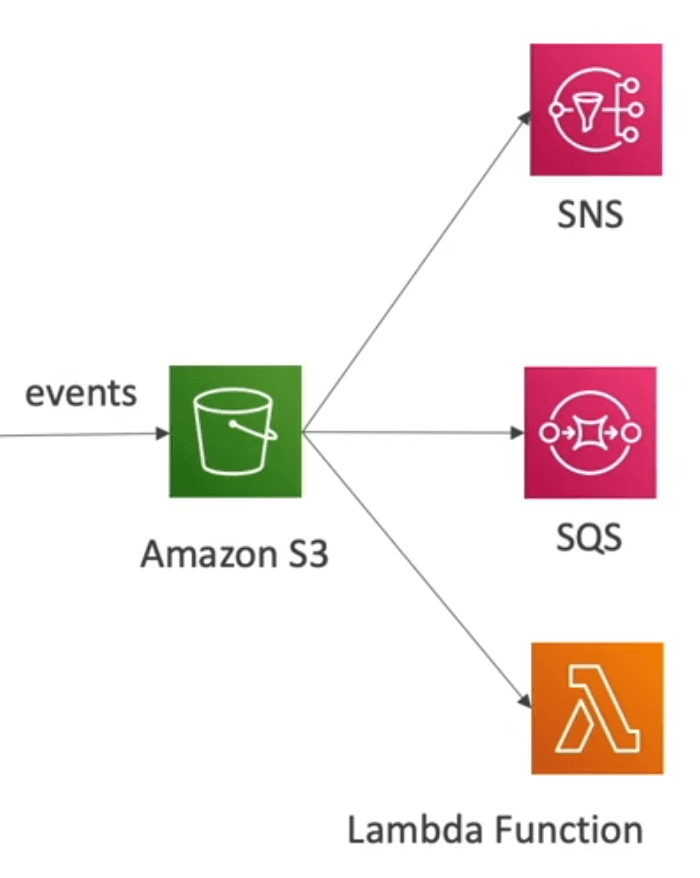
Event Notifications
Cho phép cấu hình các "trigger" để gửi notification hoặc gọi xử lý backend (Lambda, SNS, SQS) khi có event xảy ra trên S3 bucket.
Vài loại event hỗ trợ
s3:ObjectCreated:*– Khi có object được upload vào bucket.s3:ObjectRemoved:*– Khi object bị xóa.s3:ObjectRestore:*– Khi object được phục hồi từ Glacier.s3:Replication:*– Khi replication hoàn tất.
Các đặc điểm kỹ thuật
- Object name filtering: Có thể filter theo pattern tên file, ví dụ: chỉ xử lý file
*.jpg,prefix/img_,... - Có thể tạo nhiều event listener cho cùng 1 bucket (ví dụ: 1 rule cho
.jpg, 1 rule cho.csv...). - Notification có thể được gửi tới:
- SNS – để broadcast.
- SQS – để xử lý bất đồng bộ (decouple).
- Lambda Function – để xử lý realtime.
Baseline Performance
- Amazon S3 tự động scale để đáp ứng các mức request rate cao, độ trễ (latency) trong khoảng 100–200 ms.
- Ứng dụng của bạn có thể đạt tối thiểu:
- 3.500 yêu cầu PUT/COPY/POST/DELETE hoặc
- 5.500 yêu cầu GET/HEAD mỗi giây trên mỗi prefix trong bucket. (5.500 là tổng số request GET hoặc HEAD có thể xử lý trên toàn bộ các object nằm trong cùng một prefix.)
- Không có giới hạn về số lượng prefix trong một bucket.
- Ví dụ (đường dẫn object => prefix):
bucket/folder1/sub1/file→ prefix là/folder1/sub1/bucket/folder1/sub2/file→/folder1/sub2/bucket/1/file→/1/bucket/2/file→/2/
→ Như vậy, bucketbucketnày đang có 4 prefix khác nhau, tương ứng với 4 nhóm dữ liệu tách biệt.
- Nếu bạn phân phối việc đọc (read) đều ra tất cả 4 prefix phía trên, bạn có thể đạt tổng cộng 22.000 GET/HEAD request mỗi giây.
Tại sao cần "nhiều prefix"?- Vì S3 scale theo prefix, nên nếu bạn nhét hết hàng triệu file vào cùng 1 prefix, thì bạn bị giới hạn 5.500 GET/s hoặc 3.500 PUT/s trên toàn bộ hệ thống.
→ Phân phối object vào nhiều prefix khác nhau = scale ngang (horizontal scaling).
- Vì S3 scale theo prefix, nên nếu bạn nhét hết hàng triệu file vào cùng 1 prefix, thì bạn bị giới hạn 5.500 GET/s hoặc 3.500 PUT/s trên toàn bộ hệ thống.
S3 Prefix là gì?
- Prefix không phải là thư mục thật, mà là phần đường dẫn của object key tính từ gốc bucket, ví dụ như
/folder1/sub1/. - S3 scale dựa trên prefix — nghĩa là mỗi prefix có throughput riêng biệt.
Tại sao phân phối prefix lại quan trọng?
- Vì S3 quản lý backend theo prefix: mỗi prefix được xử lý bởi một shard nội bộ → giúp phân tán tải và tăng throughput tuyến tính.
- Ví dụ:
- 1 prefix → max 5.500 GET/s
- 4 prefix → max ~22.000 GET/s nếu bạn phân tải đều.
Bạn thấy bài này thế nào?