Kinesis Data Analytics
Kinesis Data Analytics dành cho các ứng dụng SQL
- Phân tích thời gian thực trên Kinesis Data Streams & Firehose bằng SQL. Dành cho: Developer không chuyên stream processing, cần xử lý real-time nhanh chóng bằng SQL
- Thêm dữ liệu tham chiếu từ Amazon S3 để làm giàu (enrich) dữ liệu streaming
- Dịch vụ fully managed, không cần triển khai máy chủ
- Tự động scale theo lưu lượng dữ liệu
- Tính phí dựa trên mức tiêu thụ thực tế (pay for actual consumption rate)
- Output:
- Kinesis Data Streams: tạo stream từ kết quả truy vấn phân tích thời gian thực
- Kinesis Data Firehose: gửi kết quả truy vấn analytics đến các đích (destinations)
- Use cases:
- Phân tích dữ liệu dạng time-series
- Dashboard thời gian thực
- Chỉ số (metrics) thời gian thực
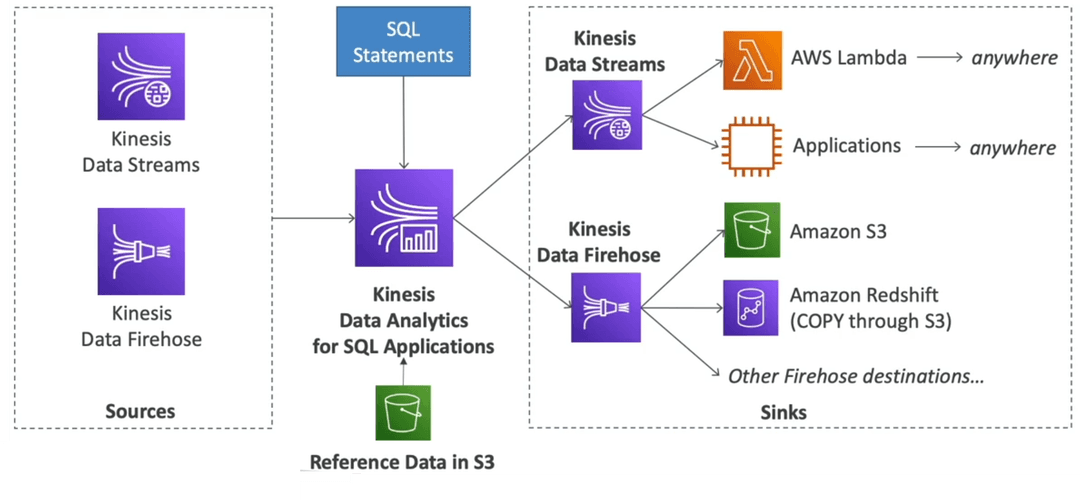
Giải thích sơ đồ
- Luồng dữ liệu đầu vào:
- Dữ liệu thời gian thực đổ về từ Kinesis Data Streams hoặc Firehose, thường là logs, event, click, metrics,...
- Với những app cần phản ứng nhanh theo real-time thì dùng Kinesis Streams.
- Với use-case cần lưu trữ hoặc phân tích theo batch thì dùng Firehose.
- Xử lý streaming với SQL:
- Kinesis Data Analytics cho phép dùng SQL chuẩn để filter, aggregate, join (lookup với data từ S3), tạo sliding/tumbling windows.
- Cực kỳ hữu ích cho các team analytics không giỏi lập trình – chỉ cần biết SQL là đủ.
- Output linh hoạt:
- Sau khi xử lý, kết quả có thể:
- Chạy vào Lambda để xử lý tùy biến (gửi cảnh báo, gọi API,...).
- Đẩy vào các hệ thống lưu trữ như S3, Redshift.
- Hoặc stream tiếp đến downstream systems.
- Sau khi xử lý, kết quả có thể:
Kinesis Data Analytics cho Apache Flink
- Sử dụng Flink (viết bằng Java, Scala hoặc SQL) để xử lý và phân tích dữ liệu streaming. Dành cho: Developer chuyên nghiệp, cần xử lý phức tạp với logic tùy biến cao → viết bằng Java / Scala / Flink SQL
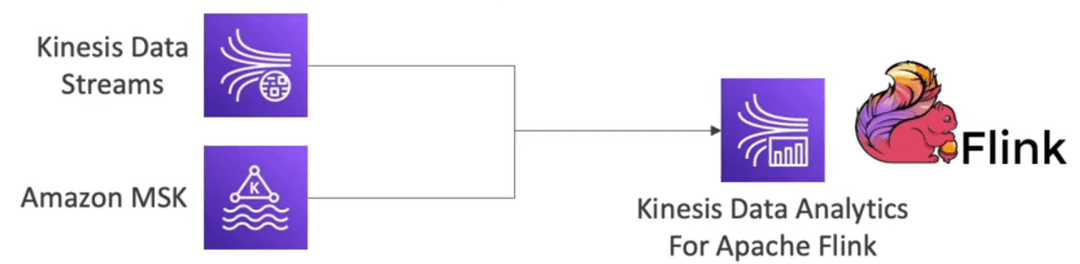
- Chạy bất kỳ ứng dụng Apache Flink nào trên managed cluster của AWS:
- Tự động cấp phát tài nguyên tính toán, thực thi song song (parallel computation), và tự động scale
- Backup ứng dụng thông qua checkpoint và snapshot
- Hỗ trợ tất cả các tính năng lập trình của Apache Flink
- Flink không thể đọc dữ liệu từ Firehose (→ sử dụng Kinesis Data Analytics for SQL nếu cần xử lý dữ liệu từ Firehose)
Hệ thống phát hiện gian lận giao dịch ngân hàng theo thời gian thực
Mô tả chung:
- Ngân hàng muốn phát hiện giao dịch bất thường (fraud) trong thời gian thực.
- Dữ liệu giao dịch liên tục đẩy vào hệ thống từ ứng dụng mobile/web của khách hàng.
- Dữ liệu bổ sung về user, hạn mức, địa điểm... được lưu trên S3.
Cách triển khai bằng Kinesis Data Analytics for SQL Applications
Mục tiêu: Filter các giao dịch bất thường dựa trên điều kiện đơn giản (ví dụ: số tiền lớn hơn 100 triệu hoặc giao dịch từ quốc gia không hợp lệ)
- Kiến trúc:
- Giao dịch → đẩy vào Kinesis Data Streams
- Trên Kinesis Data Analytics for SQL, bạn viết SQL query:
SELECT *
FROM TransactionsStream t
JOIN S3ReferenceData s
ON t.user_id = s.user_id
WHERE t.amount > 100000000
 OR t.country NOT IN ('VN', 'JP', 'US')
→ Output đẩy sang Kinesis Firehose → lưu vào S3 hoặc trigger Lambda cảnh báo
- Lợi ích:
- Không cần viết code
- Phát hiện theo rule đơn giản
- Nhanh, dễ triển khai
Cách triển khai bằng Kinesis Data Analytics for Apache Flink
Mục tiêu: Phát hiện hành vi đáng ngờ dựa theo chuỗi giao dịch trong một phiên
- Logic nâng cao:
- Nếu một user thực hiện 3 giao dịch trong vòng 2 phút, ở 3 quốc gia khác nhau → nghi ngờ gian lận.
- Cần stateful processing để lưu "lịch sử giao dịch gần nhất" theo từng user.
- Kiến trúc:
- Giao dịch → đẩy vào Kinesis Data Streams
- Flink app xử lý như sau:
// Flink code (pseudo)
KeyedStream<Transaction, String> keyed = stream.keyBy(tx -> tx.userId);
keyed
 .window(SlidingEventTimeWindows.of(Time.minutes(2), Time.seconds(10)))
 .process(new DetectSuspiciousPatternFunction())
 .addSink(alertSink);
→ Nếu phát hiện pattern gian lận → gửi alert qua SNS hoặc lưu vào Elasticsearch để điều tra
- Lợi ích:
- Phát hiện nâng cao dựa theo hành vi, sequence
- Lưu được state (và dùng checkpoint / snapshot)
- Logic linh hoạt không bị giới hạn bởi SQL
Bạn thấy bài này thế nào?