Performance - S3 Select - S3 Batch Operations
S3 Performance
Multi-Part Upload
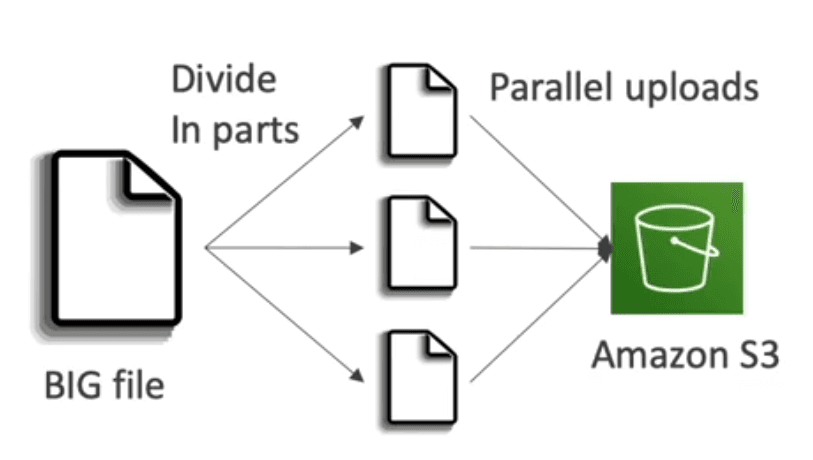
- Ý tưởng: Chia file lớn thành nhiều phần nhỏ và upload song song.
- Lợi ích:
- Khuyến nghị cho file > 100MB, bắt buộc dùng với file > 5GB
- Upload nhiều part song song → tăng tốc độ tổng thể
- Nếu 1 part lỗi → chỉ retry lại part đó (không phải reupload cả file)
- Flow:
- Chia file thành các part (tối đa 10.000 part, mỗi part tối thiểu 5MB)
- Upload các part song song lên S3
- Gửi request "CompleteMultipartUpload" để S3 ghép lại thành file hoàn chỉnh
Byte-Range Fetching
- Mục tiêu:
- Tăng tốc độ download
- Giảm lượng dữ liệu cần truyền nếu chỉ cần 1 phần file
- Tăng độ chịu lỗi khi download file lớn
- Tính năng chi tiết:
- Parallel GETs bằng cách yêu cầu theo từng range byte cụ thể
- Có thể chia file thành nhiều đoạn (byte-range) → gửi nhiều request song song để download các phần khác nhau.
- Ví dụ:
bytes=0-999bytes=1000-1999
- Tăng throughput khi tải file lớn, do dùng được nhiều kết nối đồng thời.
- Better resilience
- Nếu một request bị fail → chỉ cần retry lại phần bị lỗi.
- Không cần tải lại toàn bộ file.
So sánh: Multi-Part Upload vs Byte-Range GET
| Tiêu chí | Multi-Part Upload | Byte-Range GET |
|---|---|---|
| 🔄 Hướng xử lý | Upload (client → S3) | Download (S3 → client) |
| 🎯 Mục tiêu | Upload file lớn hiệu quả, chịu lỗi tốt | Tăng tốc download hoặc chỉ lấy 1 phần file |
| 📦 Cơ chế | Chia file thành nhiều phần → upload song song | Gửi nhiều GET request để lấy từng phần file |
| ⚙️ SDK hỗ trợ | Rất nhiều (S3 SDKs, CLI...) | Có thể dùng qua SDK hoặc REST API trực tiếp |
| 🧯 Chịu lỗi | Có thể retry từng part khi upload fail | Có thể retry part khi GET fail |
| 🛠 Kết hợp | Bắt buộc dùng nếu file > 5GB | Tùy chọn, dùng nếu cần tăng tốc hoặc lấy partial |
S3 Select và Glacier Select
- S3 Select / Glacier Select cho phép lọc dữ liệu ngay tại server (server-side filtering) → bạn chỉ tải phần dữ liệu mình cần, thay vì full file.
- Có thể dùng các câu SQL đơn giản để:
- Lọc theo row (giống
WHERE) - Chọn column cụ thể (giống
SELECT col1, col2)
- Lọc theo row (giống
- Kết quả trả về là dataset đã được lọc sẵn, giúp:
- ✅ Giảm băng thông (network transfer)
- ✅ Giảm chi phí CPU phía client
- ✅ Tăng tốc độ (nhanh hơn tới 400%)
- ✅ Giảm chi phí (tiết kiệm đến 80%)
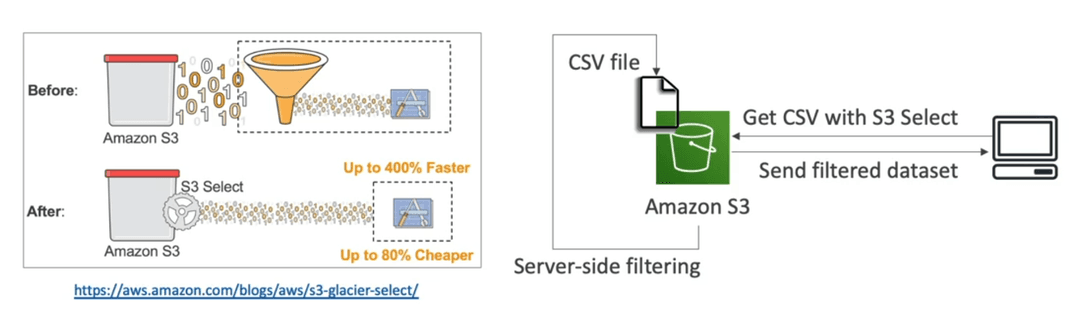
Trước khi có S3 Select:
- Toàn bộ file (ví dụ: CSV, JSON, Parquet) được tải về client.
- Việc lọc / xử lý xảy ra trên máy client → tốn tài nguyên, đặc biệt nếu file lớn.
Sau khi dùng S3 Select:
- Client gửi SQL query (ví dụ: "SELECT name FROM s3object s WHERE age > 30").
- Amazon S3 thực hiện việc lọc tại server → chỉ gửi kết quả về.
- Server-side filtering giúp giảm tài nguyên tiêu thụ, tiết kiệm chi phí và thời gian.
S3 Batch Operations
- Thực hiện các tác vụ hàng loạt trên các object S3 hiện có chỉ với một request duy nhất. Ví dụ:
- Chỉnh sửa metadata & thuộc tính của object
- Sao chép object giữa các S3 bucket
- Mã hoá các object chưa được mã hoá
- Chỉnh sửa ACLs, tags
- Khôi phục object từ S3 Glacier
- Gọi hàm Lambda để thực hiện thao tác tùy chỉnh trên từng object
- Một job bao gồm:
- Danh sách các object,
- Hành động cần thực hiện,
- Và các tham số tùy chọn
- S3 Batch Operations sẽ:
- Quản lý retry,
- Theo dõi tiến trình,
- Gửi thông báo khi hoàn thành,
- Xuất báo cáo kết quả, v.v.
- Bạn có thể dùng S3 Inventory để lấy danh sách object và dùng S3 Select để lọc các object đó
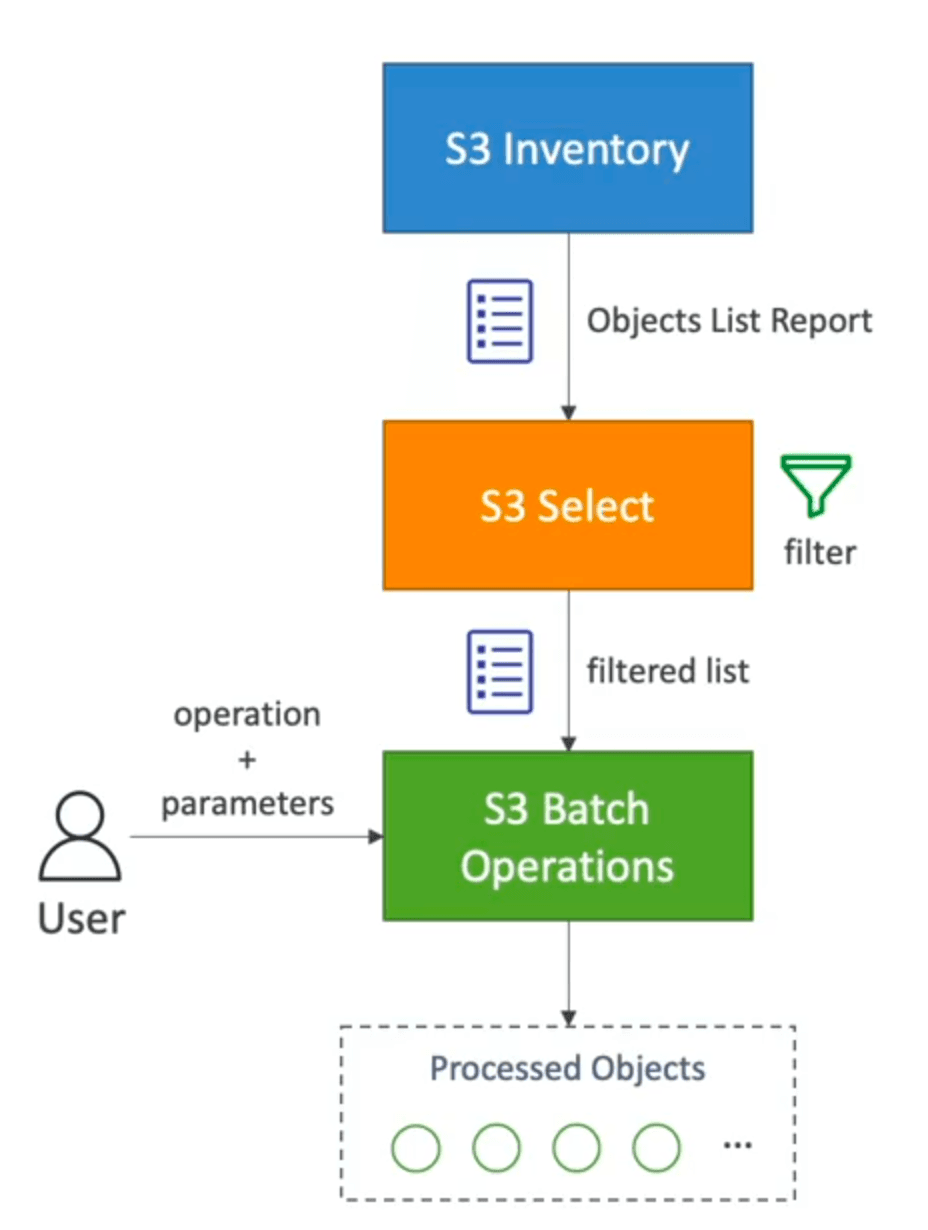
- S3 Inventory: Sinh báo cáo chứa danh sách toàn bộ object trong một bucket. Đây là input đầu vào cho các batch job.
- S3 Inventory là một tính năng built-in của Amazon S3 dùng để tạo ra danh sách các object trong bucket của bạn ở dạng báo cáo định kỳ (CSV, ORC, Parquet). Đây là giải pháp phù hợp cho auditing, phân tích dữ liệu lớn, hoặc làm input cho các batch job như S3 Batch Operations.
- Output là một file (hoặc nhiều file) lưu trong một S3 bucket khác (hoặc cùng bucket nhưng khác prefix). File chứa các thông tin chi tiết về object, ví dụ:
- Bucket – tên bucket chứa object
- Key – tên object (path tương đối)
- Size – kích thước object
- LastModifiedDate
- ETag – dùng để so sánh checksum
- StorageClass – STANDARD, GLACIER,...
- EncryptionStatus – xác định object đã được mã hoá hay chưa
- S3 Select: Cho phép bạn chạy các truy vấn SQL đơn giản lên file báo cáo từ S3 Inventory để lọc ra tập object cần thao tác (ví dụ: chỉ chọn object chưa được mã hoá).
- S3 Batch Operations: Dựa vào danh sách được lọc, thực hiện thao tác hàng loạt đã chỉ định (sao chép, mã hoá, gọi Lambda,...).
- Người dùng (user) sẽ cung cấp:
- Hành động (operation),
- Tham số liên quan (parameters),
- Và dữ liệu đầu vào (filtered list từ S3 Select).
- Cuối cùng, Processed Objects là kết quả đầu ra của toàn bộ quy trình.
Bạn thấy bài này thế nào?