AWS Lake Formation
AWS Lake Formation
- Data lake = nơi tập trung dữ liệu phục vụ cho mục đích phân tích
- Dịch vụ được quản lý toàn phần giúp dễ dàng thiết lập một data lake chỉ trong vài ngày
- Khám phá, làm sạch, chuyển đổi và ingest dữ liệu vào Data Lake
- Tự động hóa nhiều bước thủ công phức tạp (thu thập, làm sạch, di chuyển, catalog dữ liệu, ...) và loại bỏ dữ liệu trùng lặp (bằng ML Transforms)
- Kết hợp dữ liệu có cấu trúc (structured) và không có cấu trúc (unstructured) trong data lake
- Blueprint nguồn sẵn có (out-of-the-box): S3, RDS, CSDL quan hệ (Relational DB) & phi quan hệ (NoSQL DB),...
- Kiểm soát truy cập chi tiết (Fine-grained Access Control) cho ứng dụng của bạn (ở cấp độ hàng và cột – row and column-level)
- Được xây dựng trên nền tảng AWS Glue
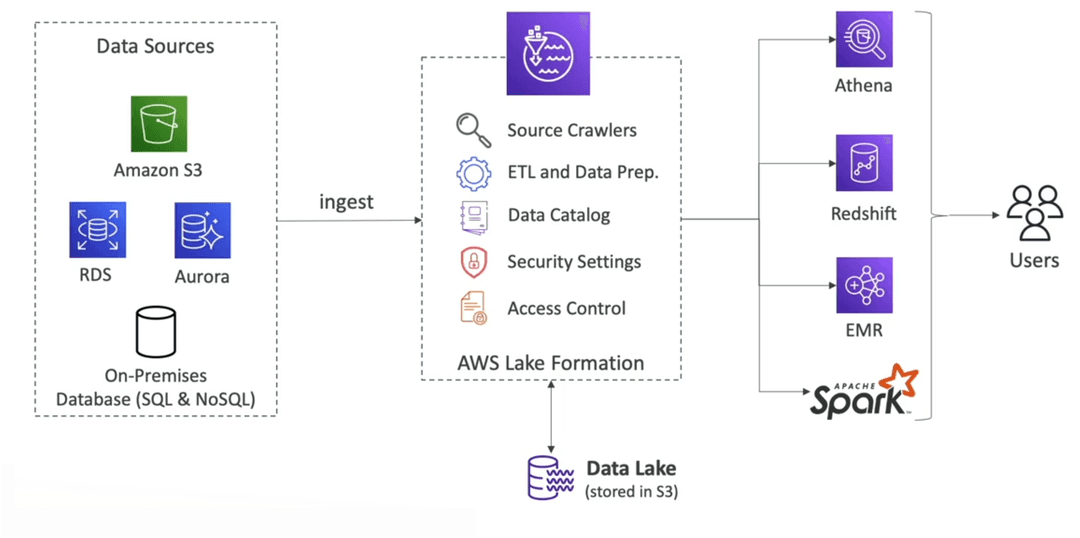
Giải thích sơ đồ
- Data Sources
- Amazon S3 – dữ liệu file (CSV, JSON, Parquet, Avro...) đã có sẵn trên cloud
- RDS / Aurora – cơ sở dữ liệu quan hệ (quan trọng với OLTP hoặc các app transactional)
- On-Premises Database – CSDL đặt tại hệ thống nội bộ (bao gồm cả SQL & NoSQL như MongoDB, Cassandra...)
🔁 Tất cả các nguồn này sẽ được ingest (nạp vào) thông qua AWS Lake Formation
- AWS Lake Formation (Trung tâm xử lý chính):
- Chức năng chính gồm:
- Source Crawlers: Dò quét và nhận diện schema tự động từ nguồn dữ liệu
- ETL and Data Preparation: Xử lý ETL (Extract, Transform, Load) và chuẩn bị dữ liệu – hoạt động này có thể tận dụng AWS Glue
- Data Catalog: Tạo catalog mô tả metadata cho dữ liệu (giúp dễ dàng truy xuất và quản lý schema)
- Security Settings: Cấu hình bảo mật – encryption, masking...
- Access Control: Thiết lập quyền truy cập chi tiết đến từng hàng, từng cột (Fine-grained access control)
➡️ Kết quả cuối cùng: Dữ liệu được chuẩn hóa và lưu trữ vào Data Lake (trên S3)
- Chức năng chính gồm:
- Consumer Layer (Tầng tiêu thụ dữ liệu):
- Từ Data Lake, người dùng (users hoặc app) có thể sử dụng dữ liệu thông qua:
- Athena: Truy vấn dữ liệu trên S3 bằng SQL mà không cần ETL
- Redshift: Dịch vụ kho dữ liệu (data warehouse) dùng để phân tích mạnh và nhanh
- EMR (Elastic MapReduce): Dùng để xử lý dữ liệu lớn, hỗ trợ framework như Spark, Hive,...
- Apache Spark: Engine xử lý phân tán rất phổ biến cho job ETL, ML, streaming
- Từ Data Lake, người dùng (users hoặc app) có thể sử dụng dữ liệu thông qua:
AWS Lake Formation - Centralized Permissions Example
Triển khai một kiến trúc Data Lake với quyền truy cập tập trung (centralized access control) và bảo mật chi tiết tới cấp độ cột (column-level security) – rất quan trọng cho các tổ chức tuân thủ bảo mật dữ liệu chặt chẽ (VD: GDPR, HIPAA...).
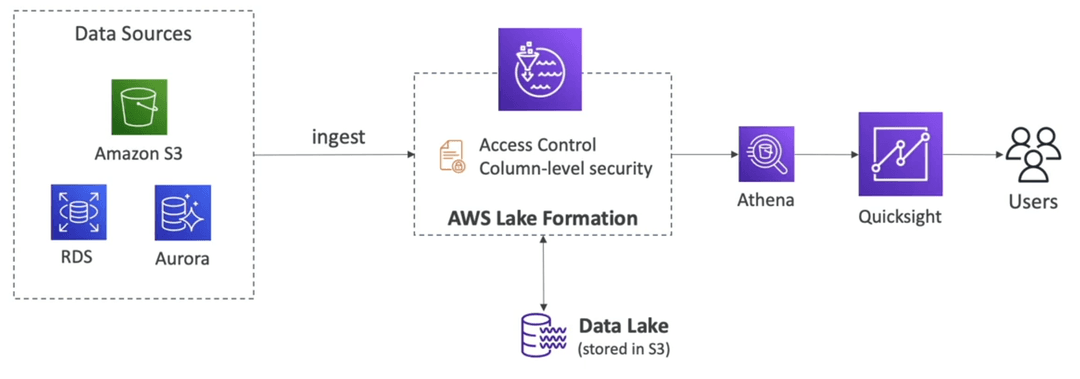
Giải thích sơ đồ
- Data Sources:
- Nguồn dữ liệu đầu vào tương tự sơ đồ trước:
- Amazon S3: file-based (CSV, JSON, Parquet...)
- RDS / Aurora: cơ sở dữ liệu quan hệ, thường là transactional DB
→ Ingest dữ liệu này vào Lake Formation
- Nguồn dữ liệu đầu vào tương tự sơ đồ trước:
- AWS Lake Formation – Vai trò trung tâm
- Chức năng chính được nhấn mạnh:
- Access Control: Phân quyền người dùng/truy vấn.
- Column-level security: Giới hạn truy cập tới từng cột trong table.
Ví dụ: Nhân viên tài chính chỉ thấysalary, không thấySSNhoặcDOB. - ✅ Đây là điểm nổi bật nhất trong sơ đồ này – kiểm soát quyền truy cập không còn đặt ở từng dịch vụ (Athena, S3...) mà tập trung tại Lake Formation.
- Chức năng chính được nhấn mạnh:
- Data Lake (stored in S3):
- Dữ liệu sau khi xử lý được lưu tại S3 theo cấu trúc chuẩn hóa, có catalog/schema do Lake Formation quản lý.
- Consumption layer:
- Athena: Truy vấn SQL trực tiếp trên data lake (sử dụng quyền từ Lake Formation)
- QuickSight: Dashboard BI trực quan hóa dữ liệu → phục vụ người dùng cuối
Bạn thấy bài này thế nào?